
시험의 종말 #2 — 시험은 조직에서 무엇을 대신 판단해 왔을까?

올해 세무사 시험 수석 합격자는 감독관 바로 앞자리에서 생성형 AI로 답을 받았습니다. 1편에서 다룬 이 사건을 부정행위로만 보면 더 큰 질문을 놓치게 됩니다. 조직은 그동안 시험 점수로 무엇을 판단해 왔을까요?
조직은 오랫동안 시험 점수로 “이 사람이 우리 일을 해낼까”라는 질문에 답해 왔습니다. 그 답은 ‘응시자는 혼자 푼다’와 ‘정답을 아는 사람이 일도 잘한다’는 두 전제 위에서 성립했고, 생성형 AI는 이 두 전제를 함께 흔들고 있습니다. 2편에서는 시험 점수가 그동안 무엇을 대신 판단해 왔고 그 판단을 왜 그대로 믿기 어려워졌는지 살펴봅니다.
조직은 채용·승진·교육에서 “이 사람이 일을 해낼까”를 시험 점수로 판단해 왔습니다
조직이 사람에 대해 내리는 결정은 크게 셋입니다. 누구를 뽑을지, 누구에게 더 큰 역할을 맡길지, 교육이 실제로 효과가 있었는지입니다. 시험은 이 세 결정에서 모두 중요한 근거였습니다. 채용에서는 인적성검사와 필기·코딩테스트, 어학 점수가, 승진에서는 승진시험과 어학·자격 요건이, 교육에서는 이수 평가 퀴즈와 사내 인증 시험이 그 역할을 맡았습니다.
시험이 이 자리를 오래 지킨 데는 이유가 있습니다. 많은 사람을 한꺼번에 평가할 수 있고, 모두에게 같은 문제와 같은 채점 기준을 적용할 수 있으며, 결과가 점수로 나와 서로 비교할 수 있습니다. 시험이 사람을 완벽하게 보여 줘서가 아니라, 이 세 가지를 한꺼번에 주는 도구가 드물었기 때문입니다. 직접 확인하기 어려운 ‘일을 해낼 능력’을 시험 점수가 대신 보여 준 셈입니다.

그 판단은 ‘혼자 푼다’와 ‘정답을 아는 사람이 일도 잘한다’는 두 전제 위에 서 있었습니다
두 전제를 풀어 쓰면 이렇습니다. 첫째, 점수는 응시자가 혼자 힘으로 낸 결과다. 둘째, 정답을 많이 아는 사람이 일도 잘한다. 첫째가 무너지면 점수가 누구의 실력인지 알 수 없고, 둘째가 약하면 점수가 높아도 일을 잘할지 알 수 없습니다.
첫째 전제 ‘혼자 푼다’는 채용 과제와 자기평가서, 교육 퀴즈에서도 흔들리고 있습니다
1편에서 본 대로, 감독관이 바로 앞에 있던 세무사 시험에서도 AI 부정행위를 잡아내지 못했습니다. 감독이 약하거나 원격으로 치르는 시험이라면 확인하기가 더 어렵습니다. 같은 일은 시험장 밖의 평가에서도 일어납니다.
채용: 결과물만으로는 지원자의 판단을 알기 어렵습니다. 지원서와 과제는 AI와 함께 쓰는 것이 자연스러워졌고, 인적성검사 같은 테스트형 평가도 원격으로 치르면 감독이 약해집니다. 완성된 결과물과 점수만 보면 그 안에 지원자 자신의 판단이 얼마나 들어 있는지 알기 어렵습니다. 서술형 문항과 대면 면접은 이 문제를 줄여 주지만, 질문이 정해진 답을 확인하는 데 머물면 효과도 제한적입니다.
승진: 자기평가서는 AI가 다듬어 줍니다. 같은 실적 메모도 AI로 정리하면 훨씬 논리적인 자기평가서가 됩니다. 문장의 완성도로 후보의 판단력과 협업 방식을 가늠하기는 점점 어려워집니다.
교육: 퀴즈를 통과했다고 내용을 이해했다고 보기 어렵습니다. 교육 뒤 치르는 이수 퀴즈도 AI에 물어 풀 수 있습니다. AI로 퀴즈를 통과한 결과만으로는 학습자가 내용을 이해했는지 확인하기 어려워집니다.
세 경우 모두 결과물과 점수는 남습니다. 다만 그 안에 본인의 판단이 얼마나 들어 있는지는 결과물만 보고 알기 어려워졌습니다.
둘째 전제 ‘정답을 알면 일도 잘한다’는 AI 이전부터 연구에서 흔들리고 있었습니다
채용 연구에서는 선발 도구마다 입사 후 성과를 얼마나 잘 맞히는지, 곧 예측력을 비교해 왔습니다. 오랫동안 기준이 된 것은 Schmidt와 Hunter가 1998년에 정리한 결과입니다. 여기서 일반 인지능력 검사는 실제 업무와 같은 과제를 해 보게 하는 실무 과제 평가 다음으로 예측력이 높은 도구였고, 채용에서 인지능력 검사를 쓰는 근거로 자주 인용됐습니다.
2022년 Sackett 등 미국 연구진은 이 결과의 바탕이 된 연구들을 다시 분석했습니다. 예전 분석이 예측력을 실제보다 크게 보정했다는 결론이었고, 보정 방식을 바로잡자 순위가 바뀌었습니다.[1] 6개 도구 가운데 일반 인지능력 검사는 공동 2위에서 4위로 내려왔습니다. 1위는 모든 지원자에게 같은 질문을 하고 같은 기준으로 채점하는 구조화 면접, 2위는 맡을 일에 필요한 지식을 묻는 직무지식 검사였습니다. 구조화되지 않은 면접과 경력 연수는 두 분석 모두에서 5위와 6위였습니다.[1][2]
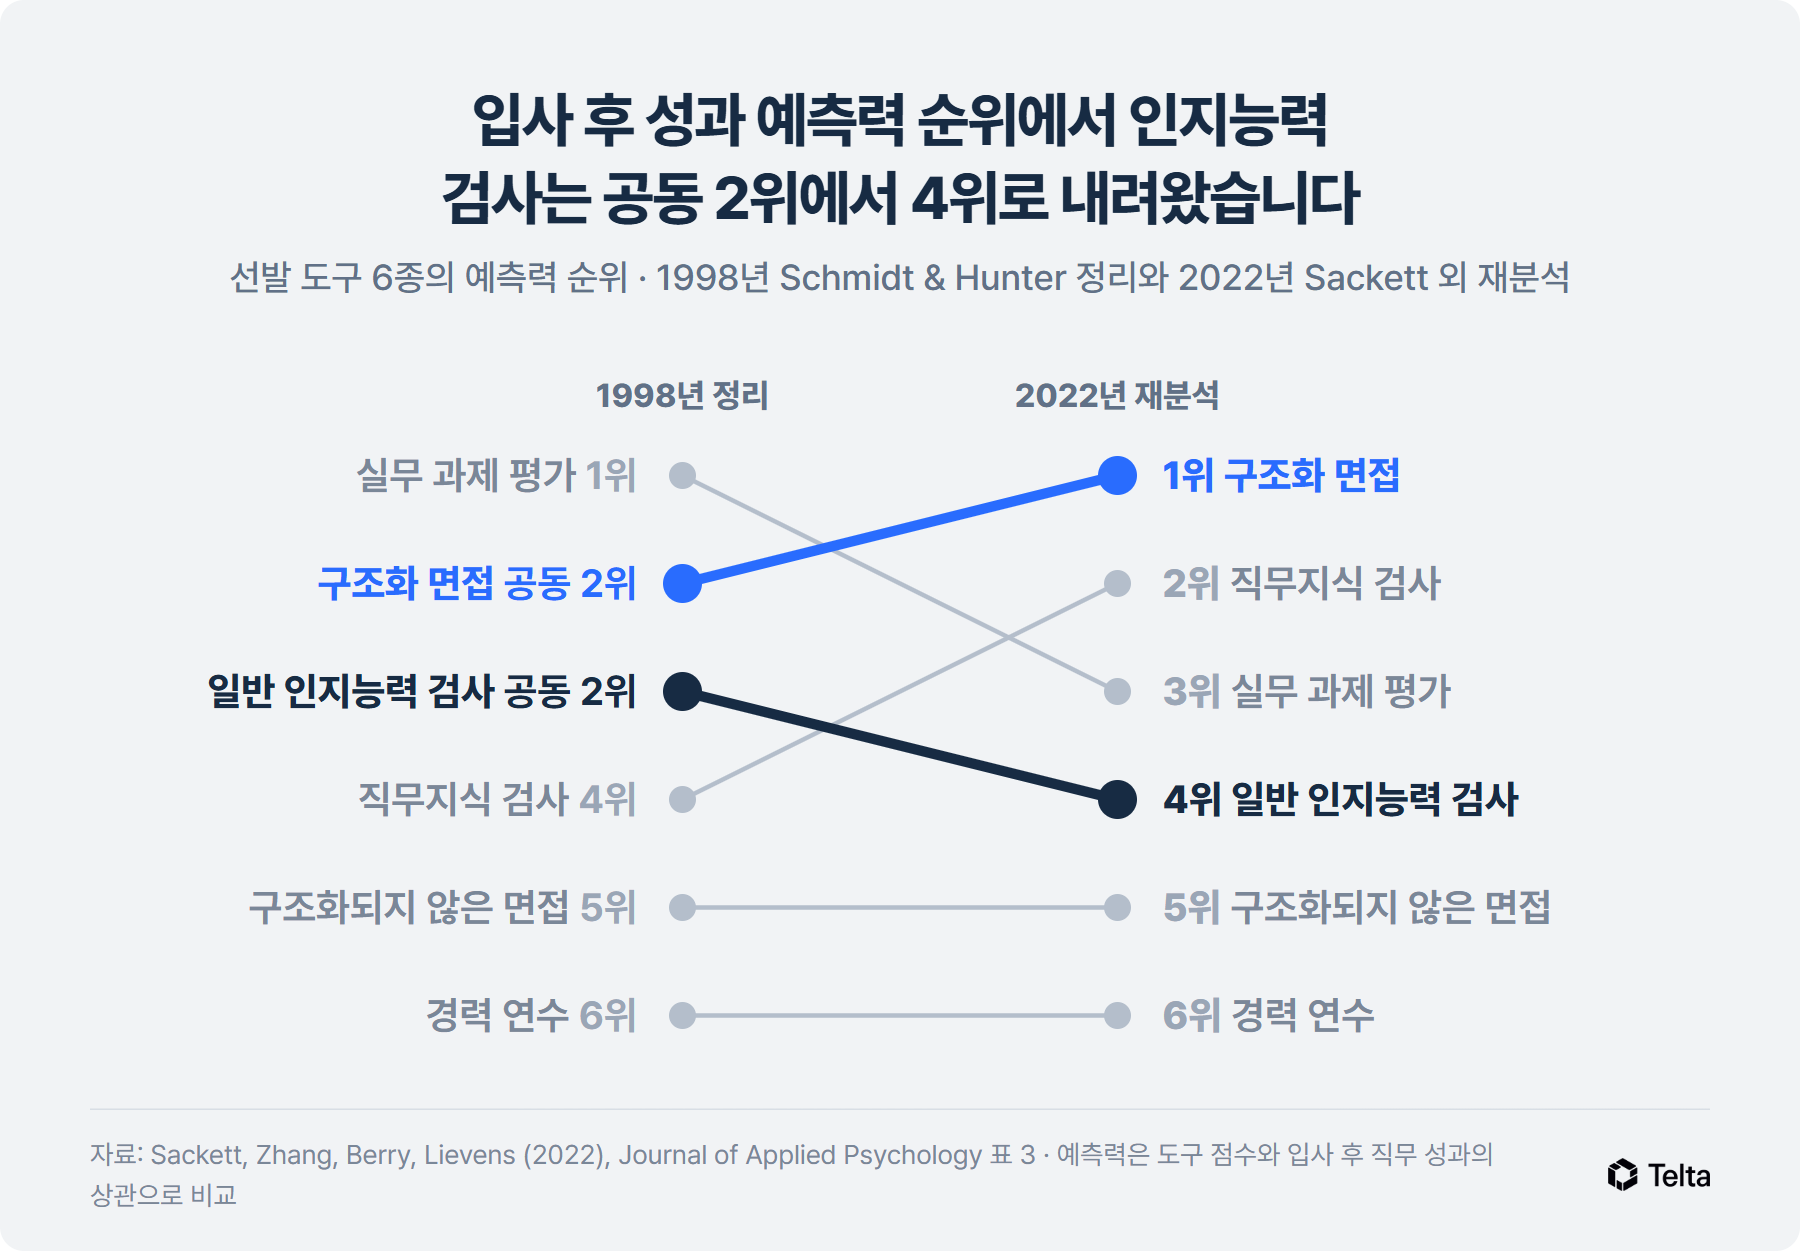
재분석에서 앞선 도구는 구조화 면접과 직무지식 검사처럼 맡을 일에 맞춰 설계하고 모두에게 같은 기준을 적용하는 방식이었습니다. 점수가 성과와 얼마나 이어지는지는 도구마다 크게 달랐고, 정답을 아는지를 넓게 묻는 검사가 가장 앞서지는 않았습니다.
AI를 쓰는 업무에서는 정답을 아는 순위와 AI로 일을 해내는 순위가 다르게 나타났습니다
AI가 일터에 들어오면서 둘째 전제는 더 약해집니다. 누구나 AI에게 물어 답을 얻을 수 있습니다. 그러면 사람 사이의 차이는 얼마나 많이 아느냐보다, AI에 일을 어떻게 맡기고 그 결과를 어떻게 검증해 판단하느냐에서 나기 시작합니다.
매일경제 디지털테크부 기자 4명이 Telta AI 리터러시 진단을 받았을 때 이 차이가 그대로 드러났습니다. 이해 영역 16문항 중 15개를 맞혀 1위를 한 기자는 활용 영역에서 Lv 2.5로 4명 중 3위였습니다. 이해 영역에서 10개를 맞힌 기자는 활용 영역에서 Lv 3.0을 받아 전체 참가자 상위 13%에 들었고, 종합 1위를 했습니다.[3]

활용 영역에서는 한 기업의 IT 직원이 되어 사내 문제를 AI로 해결해 보는 가상 과제가 주어졌습니다. 종합 1위를 한 기자는 리포트 초안을 만들 프롬프트를 AI에게 먼저 쓰게 하는 메타 프롬프팅으로 높은 평가를 받았습니다. 이해 영역 1위였던 기자는 데이터 형식과 분량을 지정해 작업을 더 잘게 나눠 보라는 조언을 받았습니다.[4] 정답 개수에는 나타나지 않는 차이입니다.
많이 쓴다고 잘 쓰는 것도 아니었습니다. Telta가 국내 기업 재직자 130명을 진단한 결과, 응답자의 76.9%가 AI를 거의 매일 쓰고 있었지만 사용 빈도와 실제 활용 역량 사이에는 통계적으로 유의한 상관이 없었습니다. 실제 활용 수준은 사람에 따라 최대 70%p 이상 벌어졌고, 매일 AI를 쓰는 사람의 절반 이상은 리스크 인식 영역에서 기준에 미치지 못했습니다.[5]

가트너는 2025년 10월 발표에서 생성형 AI 사용으로 비판적 사고력이 약해질 것으로 보고, 2026년까지 전 세계 조직의 50%가 ‘AI-free’ 역량 평가를 요구하게 될 것으로 내다봤습니다. 2027년까지 채용 과정의 75%가 업무용 AI 활용 능력을 확인하는 인증이나 테스트를 포함할 것이라는 전망도 함께 냈습니다.[6] AI 없이 생각하는 힘과 AI를 쓰는 힘을 모두 직접 확인하려는 수요가 커질 것으로 본 것입니다.
두 전제가 흔들리면서, 시험 점수만으로 “일을 해낼까”에 답하던 방식은 끝나 가고 있습니다
두 전제가 함께 흔들리면서 시험 점수만으로는 “이 사람이 우리 일을 해낼까”라는 질문에 답하기 어려워졌습니다. 점수가 본인의 실력인지 확인하기 어려워졌고, 본인의 실력이라 해도 일을 잘할지는 따로 확인해야 합니다.
그렇다고 대신할 방법 없이 시험을 없애면 더 큰 문제가 생깁니다. 많은 사람을 같은 기준으로 비교하기 어려워지고, 면접관의 인상이나 경력 연수 같은 더 약한 근거로 돌아갈 위험이 커집니다. 앞의 재분석에서도 구조화되지 않은 면접과 경력 연수는 예측력 순위의 맨 아래였습니다.[1] 인적성검사나 자격·인증은 기본기의 기준선을 확인하는 데 여전히 쓸모가 있습니다.
남는 질문은 업무 장면에서 어떻게 판단하는지를 많은 사람에게 같은 기준으로 확인하는 방법입니다. 구조화 면접과 실무 과제 평가, 평가센터처럼 그런 평가는 오래전부터 있었습니다. 이를 많은 사람에게 넓히는 데 어떤 부담이 있었는지, 시험을 흔든 AI가 평가하는 쪽에서 이를 어떻게 바꾸는지, Telta가 채용·승진·교육 현장에서 어떤 방법을 쓰고 있는지는 3편에서 살펴봅니다.
참고 자료
- Sackett, Zhang, Berry, Lievens · Revisiting meta-analytic estimates of validity in personnel selection · Journal of Applied Psychology, 2022 — 표 3, Schmidt & Hunter(1998) 추정치와 재분석 타당도 비교.
- HumRRO · Is cognitive ability the best predictor of job performance? — 재분석 결과 요약.
- Telta · 매경 디지털테크부 기자 4인의 AI 리터러시 진단 결과, 예상은 빗나갔다 · 2026.04.27.
- 매일경제 · 강영운 · AI는 ‘짬밥’ 순이 아니잖아요 · 2026.04.20 — 기자 4명의 진단 과제와 평가 내용(Daum 전재).
- Telta · AI 리터러시 리포트 2026 · 2026.04.09 — 국내 기업 재직자 130명 진단.
- Gartner · Gartner Unveils Top Predictions for IT Organizations and Users in 2026 and Beyond · 2025.10.21.


