두 지원자 모두 “AI 활용 능력이 우수하다”고 했습니다.
실제 업무에서는 어떤 차이가 있을까요?
AI 리터러시 진단
지원자와 구성원이 AI에 일을 맡기고, 답변을 검토해 결과물을 완성하는 과정을 진단합니다. 개인별 강점과 보완점, 부서·직무별 활용 수준을 리포트로 확인해 보세요.
범위·조건 없이 요청 → 검토 없이 사용
계획 → 요청 → 검토
같은 과제를 수행한 두 지원자의 가상 결과입니다. 역량군·세부 역량 레벨은 아래 결과 예시·평가 시연과 같은 값입니다.
가상 진단 예시 · 6장면
두 지원자 모두 “AI 활용 능력이 우수하다”고 했습니다.
실제 업무에서는 어떤 차이가 있을까요?
결과 리포트
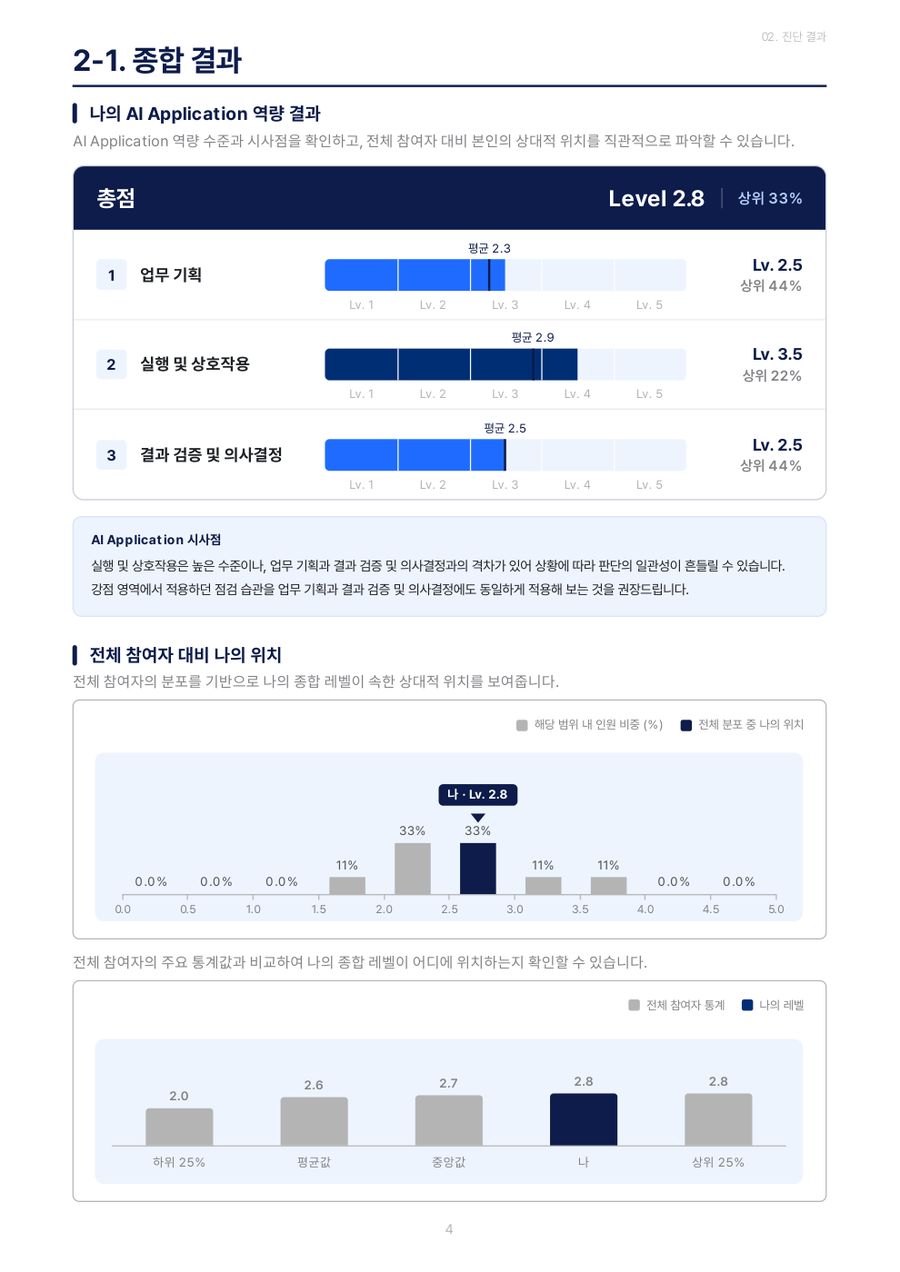
개인 리포트 · 응시자 전원
세부 역량·역량군·종합 레벨과 평가 근거, 참여자 내 상대적 위치, 대화·답안에서 확인한 활용 방식, 강점·보완점과 성장 방향을 정리합니다. 채용에는 핵심을 추린 요약 리포트를, 육성에는 피드백까지 담은 상세 리포트를 제공합니다.
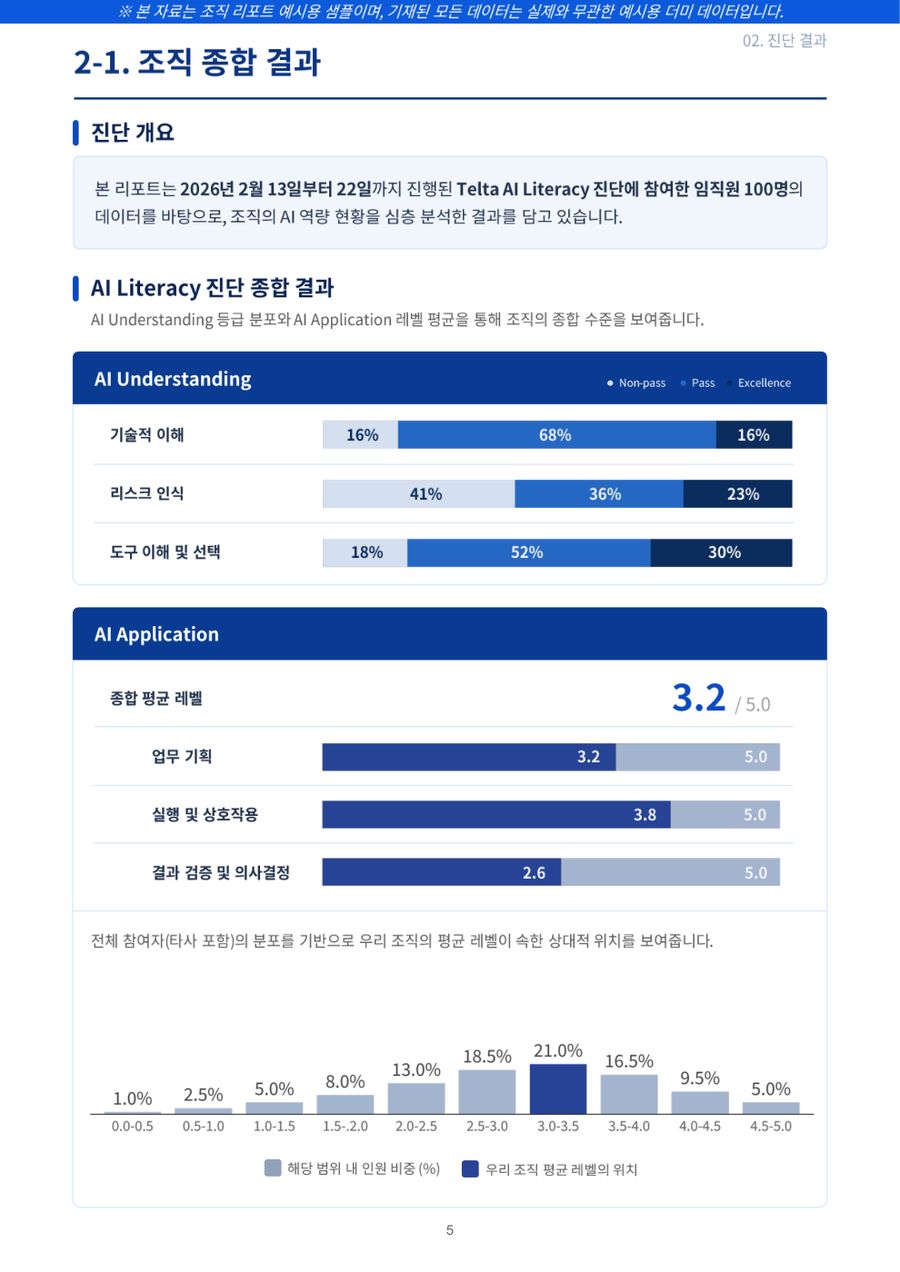
조직 리포트 · 비교가 필요할 때
조직 전체의 레벨 분포(Full은 AI 이해 등급 분포 포함)와 부서·직무별 차이, 활용 경험·계획을 비교합니다. 같은 버전으로 다시 진단하면 변화도 살펴볼 수 있습니다.
리포트 샘플의 응시자·회사·수치는 가상 데이터입니다.
필요성
지금 확인하는 사용 현황
진단으로 더 확인할 활용 역량
지원서의 AI 활용 경험을 과제에서 직접 확인합니다.
부서·직무별 AI 활용 수준과 강점·보완점을 비교합니다.
고객 정보와 내부 자료를 다루는 방식을 과제에서 살펴봅니다.
측정 방식
정답을 아는지에서, 업무에 적용하는 방식까지. AI가 만든 답변을 어떻게 검토하고 수정하는지 실제 과제로 확인합니다.
| 확인하려는 것 | 퀴즈·객관식 | 자기 평가 서베이 | 과제 수행 과정 |
|---|---|---|---|
| 업무 상황에서 AI를 쓰는 과정 | |||
| 민감 정보를 다루는 행동 | |||
| 본인 인식에 좌우되지 않는 결과 | |||
| AI에 대한 지식 | 알고 있는지 | 안다고 생각하는지 | 업무에 적용하는지 |
| 업무를 AI에게 맡기는 방식 | 확인하기 어려움 | 본인 응답으로만 확인 | AI에게 보낸 요청으로 확인 |
| AI 답변을 검증하는 방식 | 확인하기 어려움 | 본인 응답으로만 확인 | 답변을 고친 과정으로 확인 |
| 결과의 근거 | 맞힌 문항 수 | 응답 점수 | AI 대화 내역·최종 답안 |
가능어려움
객관식은 AI에 대한 이해와 판단을, 자기 평가는 본인의 인식을 살펴봅니다. Telta의 AI 활용 과제는 요청·검토·수정 과정과 최종 결과물을 확인합니다.
진단 과정
요청부터 최종 답안까지, 평가 자료로 활용합니다. 진단 화면에서 AI와 나눈 대화와 최종 결과물을 함께 분석합니다.
Task 1
AI에 맡길 일과 직접 확인할 일을 구분합니다.
Task 2
활용할 자료와 조건을 정하고, 답변을 검토해 수정합니다.
Task 3
최종 답안과 공유 전 확인할 항목을 작성합니다.
응시·평가 시연 · 단계를 선택하면 해당 장면부터 볼 수 있습니다.단계를 누르면 해당 장면부터 볼 수 있습니다.
결과 예시
지원자 A · ‘AI 활용 능력 우수’
Lv1.5
업무 기획Lv1.5
실행 및 상호작용Lv1.5
결과 검증 및 의사결정Lv1.5
고객 정보가 포함된 원본과 AI가 제시한 원인을 별도 확인 없이 사용했습니다.
지원자 B · ‘AI 활용 능력 우수’
Lv3.8
업무 기획Lv4.0
실행 및 상호작용Lv4.0
결과 검증 및 의사결정Lv3.5
고객 정보를 지우고, 근거가 없는 원인은 확인할 내용으로 구분했습니다.
설명을 위한 가상 예시 · 위 영상에 나온 두 지원자의 결과입니다.
지난주 고객 문의 300건을 주간 회의 자료로 정리하는 과제였습니다.
A는 근거 없는 원인을 그대로 썼고, B는 이를 찾아 [확인 필요]로 바꾸도록 요청했습니다.
진단 결과를 참고해, 채용·인사 담당자가 최종 판단합니다.
평가 근거
지원자 B · 요청 2
“‘물류센터 이전’은 자료에 없는 내용입니다. 원인은 [확인 필요]로 두고, 원문은 그대로 인용해 주세요.”
세부 역량
자료에 없는 원인을 찾아 수정 요청한 과정이 확인됩니다.
레벨
Lv4
지원자 B · Task 1 답안
“원문을 AI에 넣기 전에 고객 이름·전화번호를 지움”
세부 역량
AI에 제공할 정보의 범위를 먼저 정했습니다.
정식 역량명 · 사람-AI 과업 경계 설정
레벨
Lv5
설명을 위한 가상 예시입니다. 레벨은 전체 답안과 AI 대화 내역을 역량별 평가 기준에 따라 산출하며, 여기에는 대표 근거만 발췌했습니다. 세부 역량 기준 보기
6개
Telta AI가 AI 대화 내역과 최종 답안을 역량별 평가 기준에 따라 채점합니다.
개인 리포트
활용 레벨, 평가 근거, 강점·보완점과 성장 방향을 정리합니다.
리포트 활용
HR과 리더는 답변과 평가 근거를 보고, 면접에서 더 물어볼 내용과 구성원의 보완할 역량을 살펴볼 수 있습니다.
전체 역량 체계 · 6개 역량군 · 14개 세부 역량
AI의 원리와 한계, 사용 시 주의할 위험을 이해하는지 확인합니다. 보안·저작권·개인정보 같은 위험과 회사의 AI 사용 기준에 맞는 도구 선택도 함께 봅니다.
Full의 객관식 16문항으로 평가하고 역량군별 등급을 제공합니다.
업무 목적에 맞춰 AI에 일을 맡기고 답변을 검토해 결과물을 완성하는지 확인합니다.
AI 대화 내역과 최종 답안을 바탕으로 세부 역량·역량군·종합 레벨(Lv1~Lv5)을 제공합니다.
설계 기준
설계에 참고한 자료
10개 기관
OpenAI·Anthropic·Stanford·AI Alliance 등을 포함한 10개 기관의 공개 AI 역량 자료
30곳
Fortune 선정 AX 선도 기업 30곳의 직무 데이터를 분석해 반영
14개 세부 역량
AI 이해·리스크 인식 8개, AI 활용 능력 6개로 역량을 세분화해 진단
두 자료에서 도출한 역량 체계를 HR 전문가가 검토했습니다.
영업·마케팅·HR 등 여러 직무의 AI 활용 역량을 공통 기준으로 살펴봅니다.
Telta는 TalentCLEF 2026 HCM AI 모델링 Task A·B에서 종합 1위를 기록했습니다.
약 25분
Light · AI 활용 과제
약 60분
Full · 객관식 + 활용 과제
Lv1~Lv5
세부 역량별 AI 활용 레벨
1만 명+
10명 규모의 팀부터 전사 진단까지
진단 구성
AI 활용 과정에 집중한 Light, AI 이해까지 함께 보는 Full. 두 가지 진단 방식을 확인해 보세요.
하나의 업무 시나리오를 세 단계로 수행하며, AI 활용 능력 6개 세부 역량을 확인합니다.
기대 효과
객관식 16문항과 AI 활용 과제 3개로, AI 이해·리스크 인식과 AI 활용 능력 14개 세부 역량을 모두 진단합니다.
기대 효과
항목별 비교
| Light약 25분 | Full약 60분 | |
|---|---|---|
| 측정 범위 | AI 활용 능력 3개 역량군 · 6개 세부 역량 | AI 이해와 리스크 인식 + AI 활용 능력 6개 역량군 · 14개 세부 역량 |
| 구성 | 하나의 업무 시나리오를 세 단계로 수행 활용 계획·위험 검토 → AI와 대화 → 최종 결과물·검토 항목 작성 | Part 1 AI 이해 객관식 16문항 Part 2 AI 활용 과제 3개 |
| 시간 운영 | 약 25분 · 시작 후 일시정지 불가 · 단계별 시간은 응시자가 배분 | 약 60분 · 시작 후 일시정지 불가 |
| AI 사용 | 전 과정에서 진단 화면 안의 AI 대화 도구 사용 | Part 2에서 진단 화면 안의 AI 대화 도구 사용 |
| 채점 | AI 활용은 평가 기준에 따라 AI 대화 내역과 최종 답안으로, Full의 AI 이해·리스크 인식은 객관식 응답으로 평가 | |
| 결과 표시 | 세부 역량·역량군·종합 레벨(Lv1~Lv5) | AI 이해: 역량군별 등급 AI 활용: 세부 역량·역량군·종합 레벨(Lv1~Lv5) |
두 버전은 과제와 평가 기준이 서로 달라, 결과는 같은 버전끼리 비교합니다.
활용 방법
채용
Light · 약 25분
지원자의 과제 수행 방식과 요약 리포트를 보고, 면접에서 더 물어볼 내용을 준비합니다.
구성원 육성
Full · 약 60분
구성원별 강점과 보완점을 상세 리포트로 전하고, 일정 기간 뒤 같은 버전으로 다시 진단해 변화를 비교합니다.
조직 현황
조직 리포트
레벨 분포와 세부 역량 차이를 비교해, 어느 영역을 더 살펴볼지 정리합니다.
응시자 모두에게 개인 리포트를 제공합니다. 특정 직무·산업에 맞춘 진단은 협의해 개발할 수 있습니다.
응시 방법·운영
응시 방법
안내받은 링크로 접속해 바로 시작합니다. Light는 약 25분, Full은 약 60분이 걸리며, Light에서는 단계별 시간을 응시자가 직접 나눠 씁니다. 두 진단 모두 시작한 뒤에는 일시정지할 수 없습니다.
응시 화면
왼쪽에는 과제 문서가, 오른쪽에는 AI 대화 도구가 있습니다. 대화할 AI 모델을 골라 과제를 수행합니다.
운영 지원
진단 목적과 대상·일정을 함께 정합니다. 10명 규모의 팀부터 1만 명 이상의 전사 진단까지 운영하며, 응시자 모두에게 개인 리포트를 제공합니다.
맞춤 진단
특정 직무나 산업에 맞춘 역량 체계와 과제를 협의해 함께 개발합니다.

