직원 설문 서술형 응답 분석법: 기준표 만들기부터 실행 과제까지 5단계

직원 설문의 서술형 응답 분석은 자유 의견에서 반복되는 주제와 새로운 쟁점을 찾고, 점수와 조직의 상황을 함께 살펴 개선 과제를 정하는 작업입니다. 이 글에서는 분석 질문을 정하는 일부터 실행 책임자를 정하는 일까지 다섯 단계로 설명합니다. AI는 주제 발굴과 분류·요약에 활용하고, 중요한 해석과 실행 판단은 원문과 조직의 상황을 확인하며 이어 갑니다.
가령 설문이 끝난 뒤 수천 줄의 자유 의견을 읽고도 결론이 “올해도 소통이 문제”에 머문다면, 다음에는 무엇을 바꿔야 할까요. 출발점은 같은 단어를 모으는 데서 한 걸음 더 들어가는 것입니다. 응답에서 반복되는 주제를 찾고 다듬는 방법을 설명한 Braun과 Clarke의 2006년 논문을 바탕으로, 구성원의 말을 실행 과제로 옮기는 순서를 살펴보겠습니다. [1]
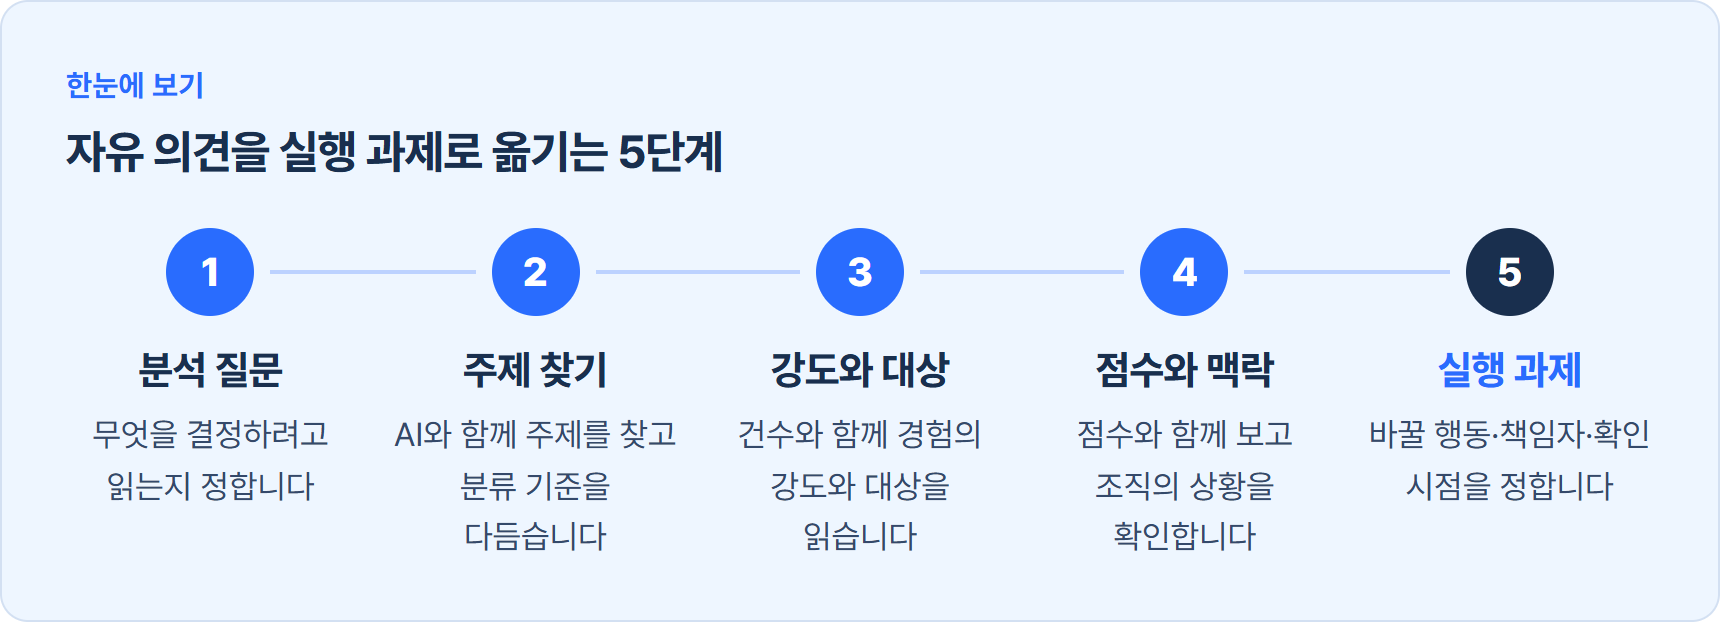
1. 무엇을 결정하려고 읽는지부터 정합니다
분석을 시작할 때는 이번 결과로 내려야 할 결정을 한 문장으로 적어 보기를 권합니다. 올해 조직문화 과제 두 가지를 고르는 것인지, 이직이 늘어난 본부의 사정을 알아보려는 것인지, 새 평가제도에 대한 반응을 확인하려는 것인지부터 정합니다. 그 질문을 기준으로 어떤 응답을 자세히 읽고 어디까지 나눌지 판단합니다.
우리 조직에서 평가제도에 대한 반응을 살펴본다면, ‘보상’이라는 큰 주제 안에서도 금액 수준과 평가 기준, 결과를 설명하는 절차를 나눠 볼 수 있습니다. 읽은 내용을 빠짐없이 나열하는 데서 끝내지 않도록, 각 주제가 처음 정한 질문에 어떤 답을 주는지도 함께 적습니다. 아직 답하기 어려운 부분은 추가로 확인할 질문으로 남겨 둡니다.
설문을 설계하는 단계라면 서술형 문항에도 같은 질문을 적용해 볼 수 있습니다. “기타 의견을 자유롭게 적어 주세요” 대신 “지난 3개월 동안 일하기 가장 어려웠던 순간을 하나 적어 주세요”처럼 경험을 묻는 방식입니다. 처음 운영하는 회사라면 문항을 두세 개로 좁히고, 각 답변을 어떤 결정에 쓸지 먼저 정해 보기를 권합니다.
AI가 서술형 분석을 잘하게 될수록 사람의 일은 줄어들기보다 자리를 옮깁니다. 반복되는 주제를 찾고 기준표를 다듬는 중간 과정은 AI가 빠르게 해내고, 이어서 볼 연구들도 정해진 기준으로 나누는 일에서는 사람에 가까운 성과를 보여 줍니다. 다만 새 주제를 세우거나 행간을 읽는 일은 아직 편차가 큽니다. 그래서 사람의 시간은 처음에 무엇을 결정하려고 읽는지 정하는 일, 그리고 마지막에 그 결과를 조직의 사정에 비추어 판단하는 일로 옮겨 가야 합니다. 중간을 AI에 맡길수록 앞뒤를 사람이 단단히 잡아야, "올해도 소통이 문제"라는 결론을 더 빨리 반복하는 일을 피할 수 있습니다.
2. AI와 함께 주제를 찾고 분류 기준을 다듬습니다
주제를 찾는 방법은 두 가지입니다. 기존 설문 영역이나 분석 질문에서 출발할 수도 있고, 응답을 읽으며 새로운 의미를 찾아갈 수도 있습니다. Braun과 Clarke가 설명한 주제 분석에도 두 접근이 모두 포함됩니다. 처음부터 완성된 기준표를 사람이 만들어 놓아야 분석을 시작할 수 있는 것은 아닙니다. [1]
최근 LLM은 분류할 주제와 그 정의를 제안하고, 비슷한 의견을 묶거나 서로 다른 경험을 나누는 데도 활용할 수 있습니다. 먼저 AI에 반복되는 주제와 이를 뒷받침하는 응답을 함께 제시하도록 요청해 보십시오. 기존 항목에 들어가지 않는 의견도 따로 남기게 하면, 미리 정한 틀 때문에 새로운 쟁점을 놓치는 일을 줄일 수 있습니다.
2026년 PLOS Digital Health에 실린 연구는 의료 분야 포커스그룹 기록을 대상으로 GPT-5·Claude 4 Sonnet 등의 분석을 인간 분석자와 비교했습니다. 정해진 코드로 분류하는 과제에서 두 모델은 전문가 합의 결과와 일치하는 정도가 인간 분석자와 비슷하거나 근소하게 높았습니다. 주제를 새로 도출하는 과제에서는 모델별 성과가 더 엇갈렸습니다. 이 결과는 AI가 정성 분석의 상당 부분을 맡을 수 있음을 보여 주며, 과제에 따라 결과를 확인할 필요도 함께 보여 줍니다. [2]
서술형 설문에 더 가까운 최근 자료도 있습니다. 2026년 8월 공개된 사전논문은 유럽 박사과정 학생 설문의 응답 903개를 인간 코더 5명과 GPT-5.4가 분석한 결과를 비교했습니다. 분류와 주제 생성에서 인간과 모델 사이의 일치도가 관찰됐고, 연구진은 해당 자료에서 인간의 분석에 근접할 수 있다고 해석했습니다. 아직 사전논문이며, 분석한 질문에 따라 일치도 차이가 컸습니다. [6]
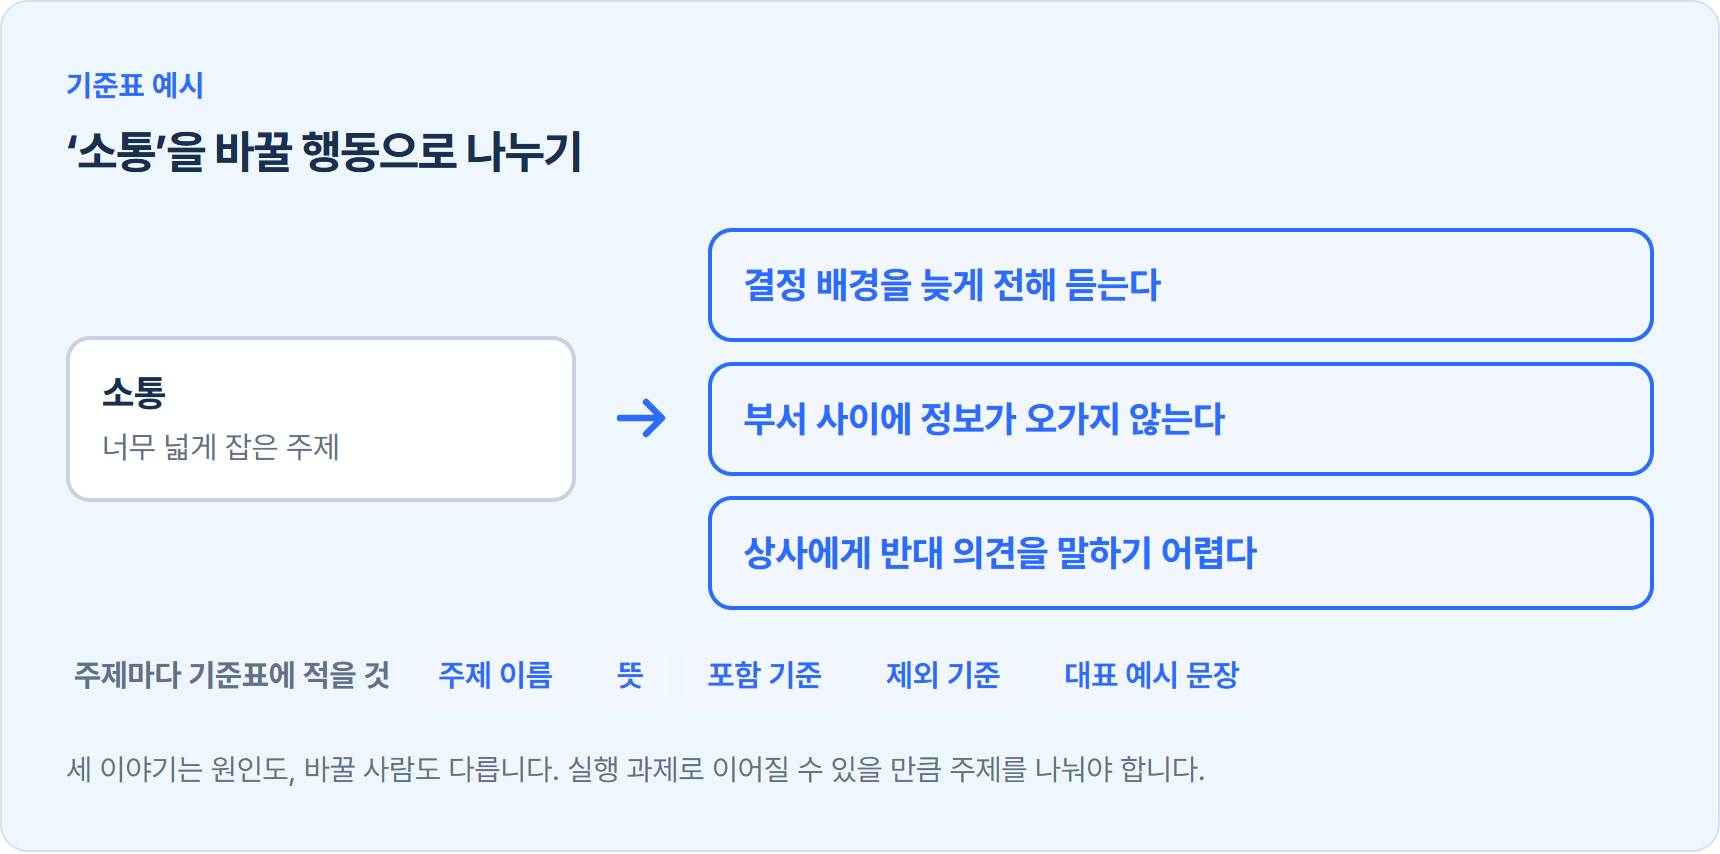
이렇게 찾은 주제를 반복해서 비교하거나 여러 사람이 함께 사용할 때는 분류 기준을 정리해 두면 좋습니다. 각 주제의 뜻과 포함·제외할 내용, 대표 응답을 적은 표가 코드북입니다. AI가 초안을 만들고 응답을 추가로 읽으며 고칠 수 있습니다. 응답이 적다면 우선 전체를 읽고 필요한 주제만 정리하는 방식으로 시작해도 됩니다.
가령 ‘소통’이라는 묶음 안에서도 결정 배경을 늦게 전해 듣는 경험, 부서 사이에 정보가 오가지 않는 경험, 상사에게 반대 의견을 말하기 어려운 경험은 구분할 수 있습니다. 어떤 행동을 바꾸면 좋을지 떠올려 보며 주제의 경계를 다듬습니다. 한 응답에 여러 경험이 담기면 주제를 여러 개 붙이고, 기존 분류로 설명되지 않는 의견은 새 주제로 검토합니다.
AI가 제안한 분류는 원문과 함께 확인합니다. 경계가 모호한 응답, 새로운 주제, 중요한 대응으로 이어질 의견부터 살펴보고, 같은 주제로 묶인 응답 일부를 읽어 의미가 일관되는지 봅니다. 기준을 바꿨다면 앞서 분류한 응답에도 적용합니다. 매번 같은 인원과 응답 수를 맞추기보다 자료의 양과 판단의 중요도에 맞춰 검토 범위를 정할 수 있습니다.
3. 언급 건수와 함께 의견의 강도와 대상을 읽습니다
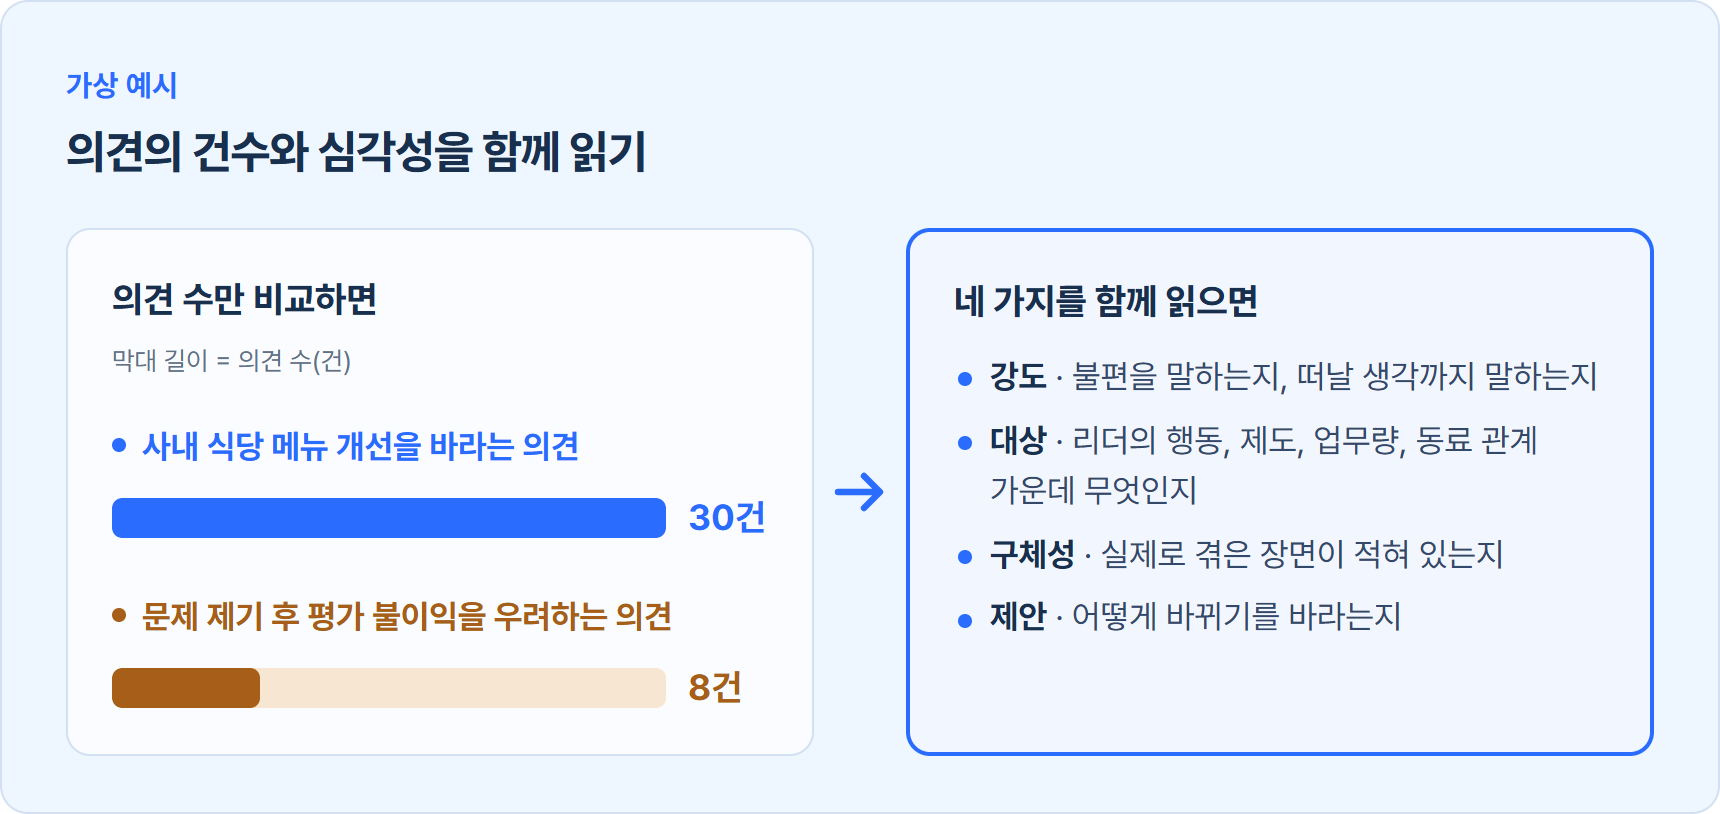
우리 팀의 의견을 살펴본다고 가정해 보겠습니다. 사내 식당 메뉴에 관한 의견이 서른 건이고, 문제를 제기하면 평가에서 불이익을 받을까 걱정된다는 의견이 여덟 건입니다. 이때 건수와 함께 각 의견이 어떤 경험을 말하고, 어떤 대응을 요구하는지 살펴봅니다. 보고서에서도 두 주제의 언급 수와 검토할 내용을 나란히 적어 볼 수 있습니다.
응답을 읽을 때는 강도·대상·구체성·제안을 함께 기록해 보기를 권합니다. 불편을 말하는지 떠날 생각까지 말하는지, 리더의 행동과 제도 중 무엇을 향하는지 살펴봅니다. 이어 구체적인 경험이 적혀 있는지, 어떤 변화를 바라는지 읽습니다. 이 네 가지를 정리하면 같은 주제 안에서도 더 확인할 질문을 구체적으로 적을 수 있습니다.
가령 ‘보상 불만’으로 분류한 응답에서도 금액 수준에 대한 의견과 평가 기준을 모르겠다는 의견을 나눠 읽어 봅니다. 전자는 보상 수준과 예산을, 후자는 기준을 설명하는 방식과 절차를 살펴볼 출발점이 됩니다. 긍정·부정이라는 표시를 붙였더라도, 실행 과제를 정할 때는 구성원이 무엇에 대해 어떤 경험을 적었는지 원문으로 돌아가 확인합니다.
4. 점수와 함께 읽고, 조직별 맥락을 확인합니다
가령 몰입 점수가 떨어진 본부에서 업무량에 관한 의견도 반복된다면, 업무량을 점수 하락과 연결해 살펴볼 가설로 적을 수 있습니다. Telta의 2026년 10월 11일 글도 점수와 의견을 읽을 때 행동과 맥락을 더 확인할 것을 제안합니다. 구성원의 응답으로 확인한 경험과, 그 경험이 점수에 영향을 줬다는 판단을 구분하며 읽는 것입니다. 조직문화 진단 결과 해석 글
우리 조직에서 점수가 비슷한 두 부서를 비교한다면 자유 의견에 담긴 장면도 함께 살펴볼 수 있습니다. 한쪽에서만 리더의 의사결정 방식이 반복해서 언급된다면, 어떤 결정을 떠올렸는지 확인할 질문을 준비합니다. 점수와 주제가 함께 나타난 대목을 기록하고, 구성원과의 후속 대화에서 그 연결을 더 살펴보는 방식입니다.
조직별 보고 범위를 정할 때는 최소 응답 인원과 원문 인용 기준도 함께 정해 두기를 권합니다. 예를 들어 5명 미만인 조직은 상위 본부에 합쳐 보는 방식을 검토할 수 있습니다. 원문에서는 직급과 프로젝트 이름, 특정 사건의 조합으로 작성자를 짐작할 여지가 있는지 살피고, 공개할 문장을 정할 때 의미와 익명성을 함께 확인합니다.
보고서에 실을 문장은 주제별 응답 묶음으로 돌아가 골라 보기를 권합니다. 가장 격하거나 눈에 띄는 표현부터 고르기보다, 해당 주제로 묶은 이유를 보여 주는 문장을 찾는 것입니다. 인용문 옆에는 그 주제에서 반복된 내용과 다른 의견도 함께 정리해, 독자가 한 문장과 전체 응답의 관계를 살펴볼 수 있도록 합니다.
5. 확인할 가설과 실행 책임자를 함께 정합니다
이제 주제별 정리를 다음 행동으로 옮길 차례입니다. 우리 팀에서 결정 배경을 미리 공유받지 못한다는 의견을 다룬다면, 먼저 어떤 상황을 확인할지 적어 볼 수 있습니다. 결정 후에 알리는 관행이 있는지, 상위 조직의 결정을 전달하는 과정에서 설명이 빠지는지 살펴보고, 그 결과에 따라 바꿀 행동을 정합니다.
이 과제를 계획으로 옮긴다면 ‘팀에 영향을 주는 결정을 확정하기 전에 배경을 짧게 공유한다’는 행동을 정해 볼 수 있습니다. 담당은 해당 조직의 리더로 두고, 두 달 뒤 짧은 후속 설문에서 같은 문항을 다시 묻는 일정도 함께 잡습니다. 처음 세운 가설과 실제로 해 본 행동, 구성원이 느낀 변화를 차례로 돌아보는 방식입니다.

결과를 구성원에게 돌려주는 일정도 계획에 포함합니다. 어떤 의견을 읽었고 이번 분기에 무엇부터 바꿀지, 언제 다시 확인할지 설명하는 것입니다. Telta의 2026년 10월 12일 글은 결과를 해석할 사람과 시간, 현업 책임자를 정하는 일을 다룹니다. 과제를 맡을 사람과 후속 점검이 필요한 대목은 「조직문화 진단, 보고서는 나왔는데 왜 아무것도 안 바뀔까?」에서 이어서 살펴볼 수 있습니다.
결과 보고가 끝나면 흔히 "건수 1위가 소통이니 전사 소통 교육부터 하자"는 결론이 납니다. 그런데 2단계에서 나눠 본 것처럼 소통 의견 안에는 결정 배경을 늦게 듣는 팀, 부서 간 정보가 막힌 본부, 반대 의견을 말하기 어려운 조직이 섞여 있습니다. 그래서 교육 하나로는 어느 곳도 달라지지 않기 쉽습니다. 반대로 몇 건뿐인 "문제를 말하면 불이익을 받는다"는 의견은 건수와 상관없이 먼저 다뤄야 할 신호입니다. 실행 순서는 건수가 아니라 의견의 강도, 그 의견이 향한 대상, 어느 조직에서 어떤 사정으로 나왔는지를 함께 보고 정해야 합니다.
AI와 함께 해석하고, 실행할 과제를 정합니다
AI에는 주제 제안, 기준표 작성, 분류와 요약, 대표 응답 찾기까지 맡길 수 있습니다. 각 결과에 근거가 된 원문을 연결해 두면 해석을 확인하기 쉽습니다. 주제를 합치거나 나눌 때는 그 이유를 요청하고, 요약에서 빠진 소수 의견과 다른 해석도 함께 살펴봅니다.

분석 결과를 실행으로 옮길 때는 회사가 바꿀 수 있는 행동과 필요한 의사결정을 정합니다. AI가 제시한 우선순위를 참고하되, 의견의 심각성·조직의 여건·책임 범위를 함께 판단합니다. 괴롭힘이나 부당한 대우를 알리는 의견은 주제별 집계와 별도로 살펴볼 담당과 절차를 마련해 두는 것이 좋습니다.
서술형 분석을 마칠 때는 주제별 응답 묶음과 함께, 더 확인할 질문·바꿀 행동·책임자·다시 살펴볼 시점을 남겨 보십시오. 그 목록을 처음 정한 분석 질문과 나란히 놓으면, 이번 결과로 결정할 수 있는 일과 후속 대화가 필요한 일을 정리할 수 있습니다. 다음 설문에서는 같은 기준으로 응답을 읽으며 변화를 살펴봅니다.
Telta의 Survey Intelligence는 조직문화·리더십 서베이의 서술형 응답을 주제별로 정리해, 점수의 배경을 함께 읽을 수 있는 보고서로 제공합니다. 공식 안내 페이지에서 전사·조직별 보고서의 제공 내용을 확인할 수 있습니다. [3]
함께 읽어보면 좋은 글
참고 자료
- Braun, V. & Clarke, V. · Using thematic analysis in psychology · 2006. Qualitative Research in Psychology, 3(2), 77–101. — 주제 분석의 정의와 자료에서 주제를 찾는 접근. 공개 검색 결과에서 확인한 초록과 대학 저장소의 공개 발췌문을 사용했습니다.
- Large language models for thematic analysis in healthcare research: A blinded mixed-methods comparison with human analysts · PLOS Digital Health · 2026.04.03. — 의료 포커스그룹 자료의 연역·귀납 분석을 인간 분석자와 비교한 연구. 분류 지표와 주제 생성 결과를 구분해 인용했습니다.
- Telta · Survey Intelligence 공식 안내 · 발행일 미표기, 확인일 2026.11.01. — 서술형 응답의 주제별 정리와 전사·조직별 보고서 안내.
- Telta · 조직문화 진단 결과, ‘소통이 문제’라는 말만으로는 아무것도 바뀌지 않는 이유 · 2026.10.11. — 점수와 맥락을 함께 읽고 원인 가설을 확인하는 방법.
- Telta · 조직문화 진단, 보고서는 나왔는데 왜 아무것도 안 바뀔까? · 2026.10.12. — 결과 해석, 현업 책임자와 후속 점검에 대한 제안.
- Bergmann 외 · LLMs for Survey Text Analysis — A Performance Comparison Between Humans and GPT-5 on Inductive Content Analysis · 2026.08.23. 사전논문. — 서술형 응답 903개의 분류·주제 생성에서 인간 코더와 GPT-5.4를 비교했습니다.