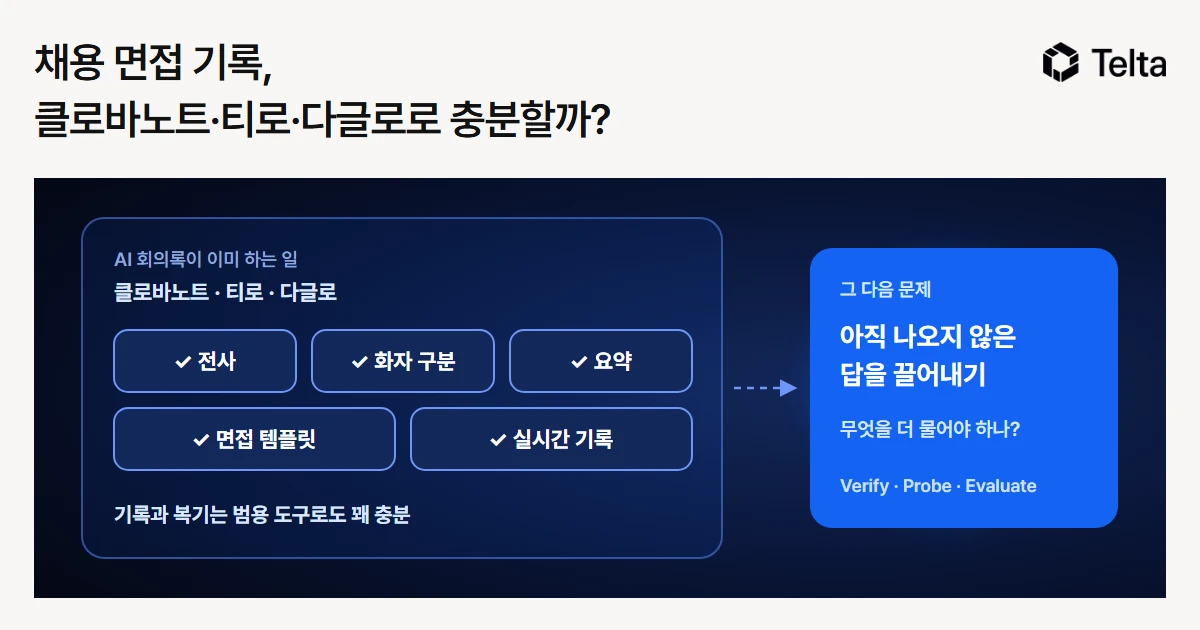
채용 면접 기록, 클로바노트·티로·다글로로 충분할까?


Interview Intelligence 시리즈 1/2
같은 23분짜리 면접을 세 가지 AI 회의록에 넣어봤습니다. 결론부터 말하면, 이번 테스트에서는 기록·복기 용도로 범용 회의록도 충분히 쓸 만했습니다. 문제는 그 다음부터였습니다.
면접이 끝난 뒤 평가서를 쓰다 보면 결국 기억에 기대게 됩니다. 그래서 면접에도 클로바노트·티로·다글로 같은 AI 회의록을 켜 두는 팀이 생깁니다.
질문은 단순합니다. 면접 내용을 정확히 남기고 나중에 복기하는 것이 목적이라면, 범용 AI 회의록으로 충분할까요?
먼저 결론
1. 기록과 복기만 놓고 보면 범용 AI 회의록도 충분히 쓸 만했습니다. 이번 테스트에서는 티로의 전사·화자 구분·전문용어 기록이 가장 안정적이었습니다.
2. 차이는 전사보다 요약에서 더 크게 났습니다. 외부 요인이 빠지거나, 회사가 한 일이 지원자 성과처럼 들어가거나, 지원자의 판단이 사실처럼 정리되는 경우가 있었습니다.
3. 일부 범용 도구는 면접용 템플릿뿐 아니라 실시간 스크립트와 요약까지 제공합니다. 다글로 ‘면접’ 템플릿은 평가 초안까지 만들고, 티로는 녹음 중에도 스크립트와 요약을 보여 줍니다.
어떻게 테스트했나요
소비재 브랜드의 이커머스 상품 MD 경력직 면접을 가정해 약 23분 30초 분량의 대본을 만들고, 면접관과 지원자 두 사람의 목소리를 합성 음성으로 녹음했습니다. 지원자와 회사는 모두 가상입니다.
답변에는 일부러 한 번 더 확인해야 하는 지점을 넣었습니다.
1. 기록: 기록·복기 용도로는 충분히 쓸 만했습니다
숫자는 세 도구 모두 30억, 25억, 32%, 광고 예산 20%, 1만 2,900원 같은 주요 수치를 틀리지 않았습니다.
화자 구분은 클로바노트(참석자 2명 지정)와 티로가 23분 내내 안정적이었고, 다글로는 중반 이후 실제로 없던 짧은 발화가 별도 참석자처럼 끼어들었습니다.
MD 면접에서 자주 쓰는 용어도 비교했습니다.
| 실제 단어 | 클로바노트 | 티로 | 다글로 |
|---|---|---|---|
| SKU | 스케줄·스케유 등 | SKU | 스케줄·스크류 등 |
| MOQ | 음모큐 | MOQ | 음모큐 |
| 공헌이익 | 공원 이익 | 공헌 이익 | 대체로 오인식, 일부 정확 |
| CS팀 | 캐스팀 | CS팀 | 캐스팅 |
| ROAS | roas | ROAS | ROAS |
이번 1건의 합성음성 테스트 결과입니다. 실제 회의 환경, 마이크, 화자 억양에 따라 달라질 수 있습니다.
같은 면접을 넣은 Telta(텔타) Interview Pro도 화자 구분과 주요 숫자는 안정적이었고, 전문용어는 SKU·MOQ·공헌이익·ROAS 4개를 맞혔습니다(‘CS팀’은 “캐스팅”). 마이크 입력이라 순위는 매기지 않았습니다.
이번 테스트만 놓고 보면 “면접 내용을 남겨두고 다시 찾아본다”는 문제는 이미 범용 AI 회의록이 상당히 잘 풀고 있었습니다.
2. 면접이 끝나기 전에도 기록을 볼 수 있을까?
| 클로바노트 | 티로 | 다글로 | Interview Pro | |
|---|---|---|---|---|
| 면접 중 실시간 스크립트 | 웹 녹음 중 표시 안 됨 종료 후 변환 | 말하는 동시에 표시 | 웹 녹음 중 표시 안 됨 종료 후 받아쓰기 | 실시간 표시 |
| 화자 구분 | 종료 후 | 종료 후(Pro 플랜) | 종료 후 | 실시간 |
| 면접 중 실시간 요약 | 종료 후 ‘요약’ 버튼으로 생성 | 시간순 요약 실시간 생성 | 종료 후 기본·템플릿 요약 | 답변 단위 요약 |
2026년 10월 12일 같은 음원 앞 6~7분으로 확인. 클로바노트·다글로는 웹(PC) 녹음 기준이며 모바일 앱은 확인하지 않았습니다. 티로는 공식 문서 기준입니다.
티로는 녹음 중에도 스크립트와 시간순 요약을 보여 줍니다. Interview Pro 역시 실시간 스크립트와 답변 단위 요약을 제공합니다. 하지만 여기까지는 범용 제품과 겹치는 영역입니다.
차이는 그 기록을 보고 지금 무엇을 더 물어야 하는지 판단하는 순간부터 생깁니다. 이미 나온 답을 잘 기록하는 것과, 아직 나오지 않은 답을 끌어내는 것은 다른 문제입니다.
3. 그런데 요약에서 중요한 맥락이 달라졌습니다
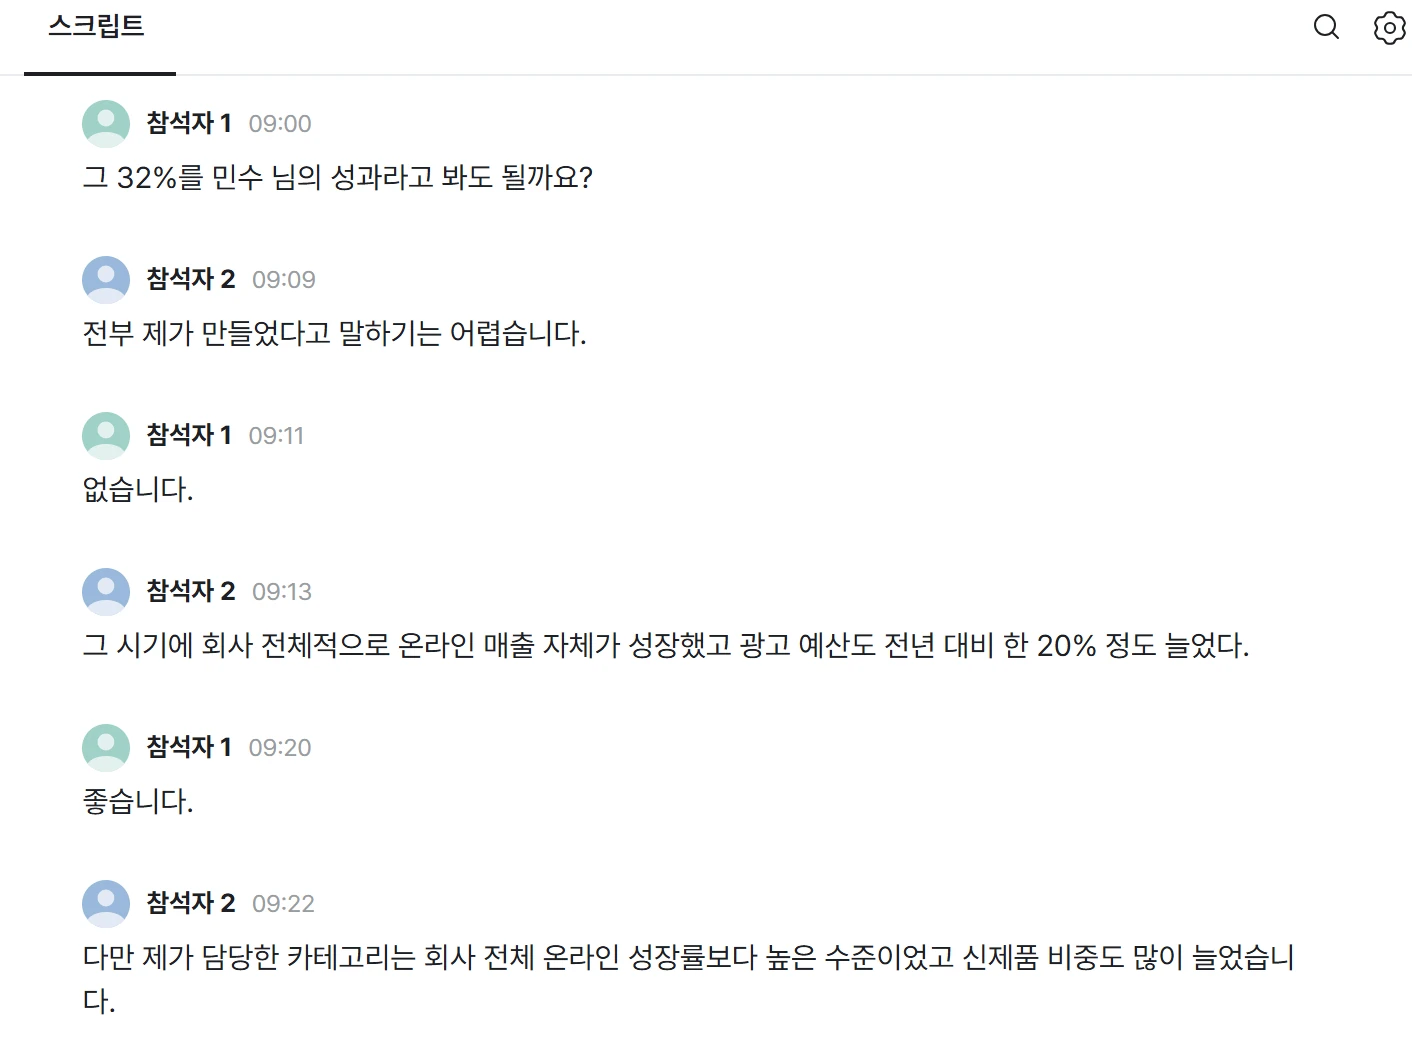
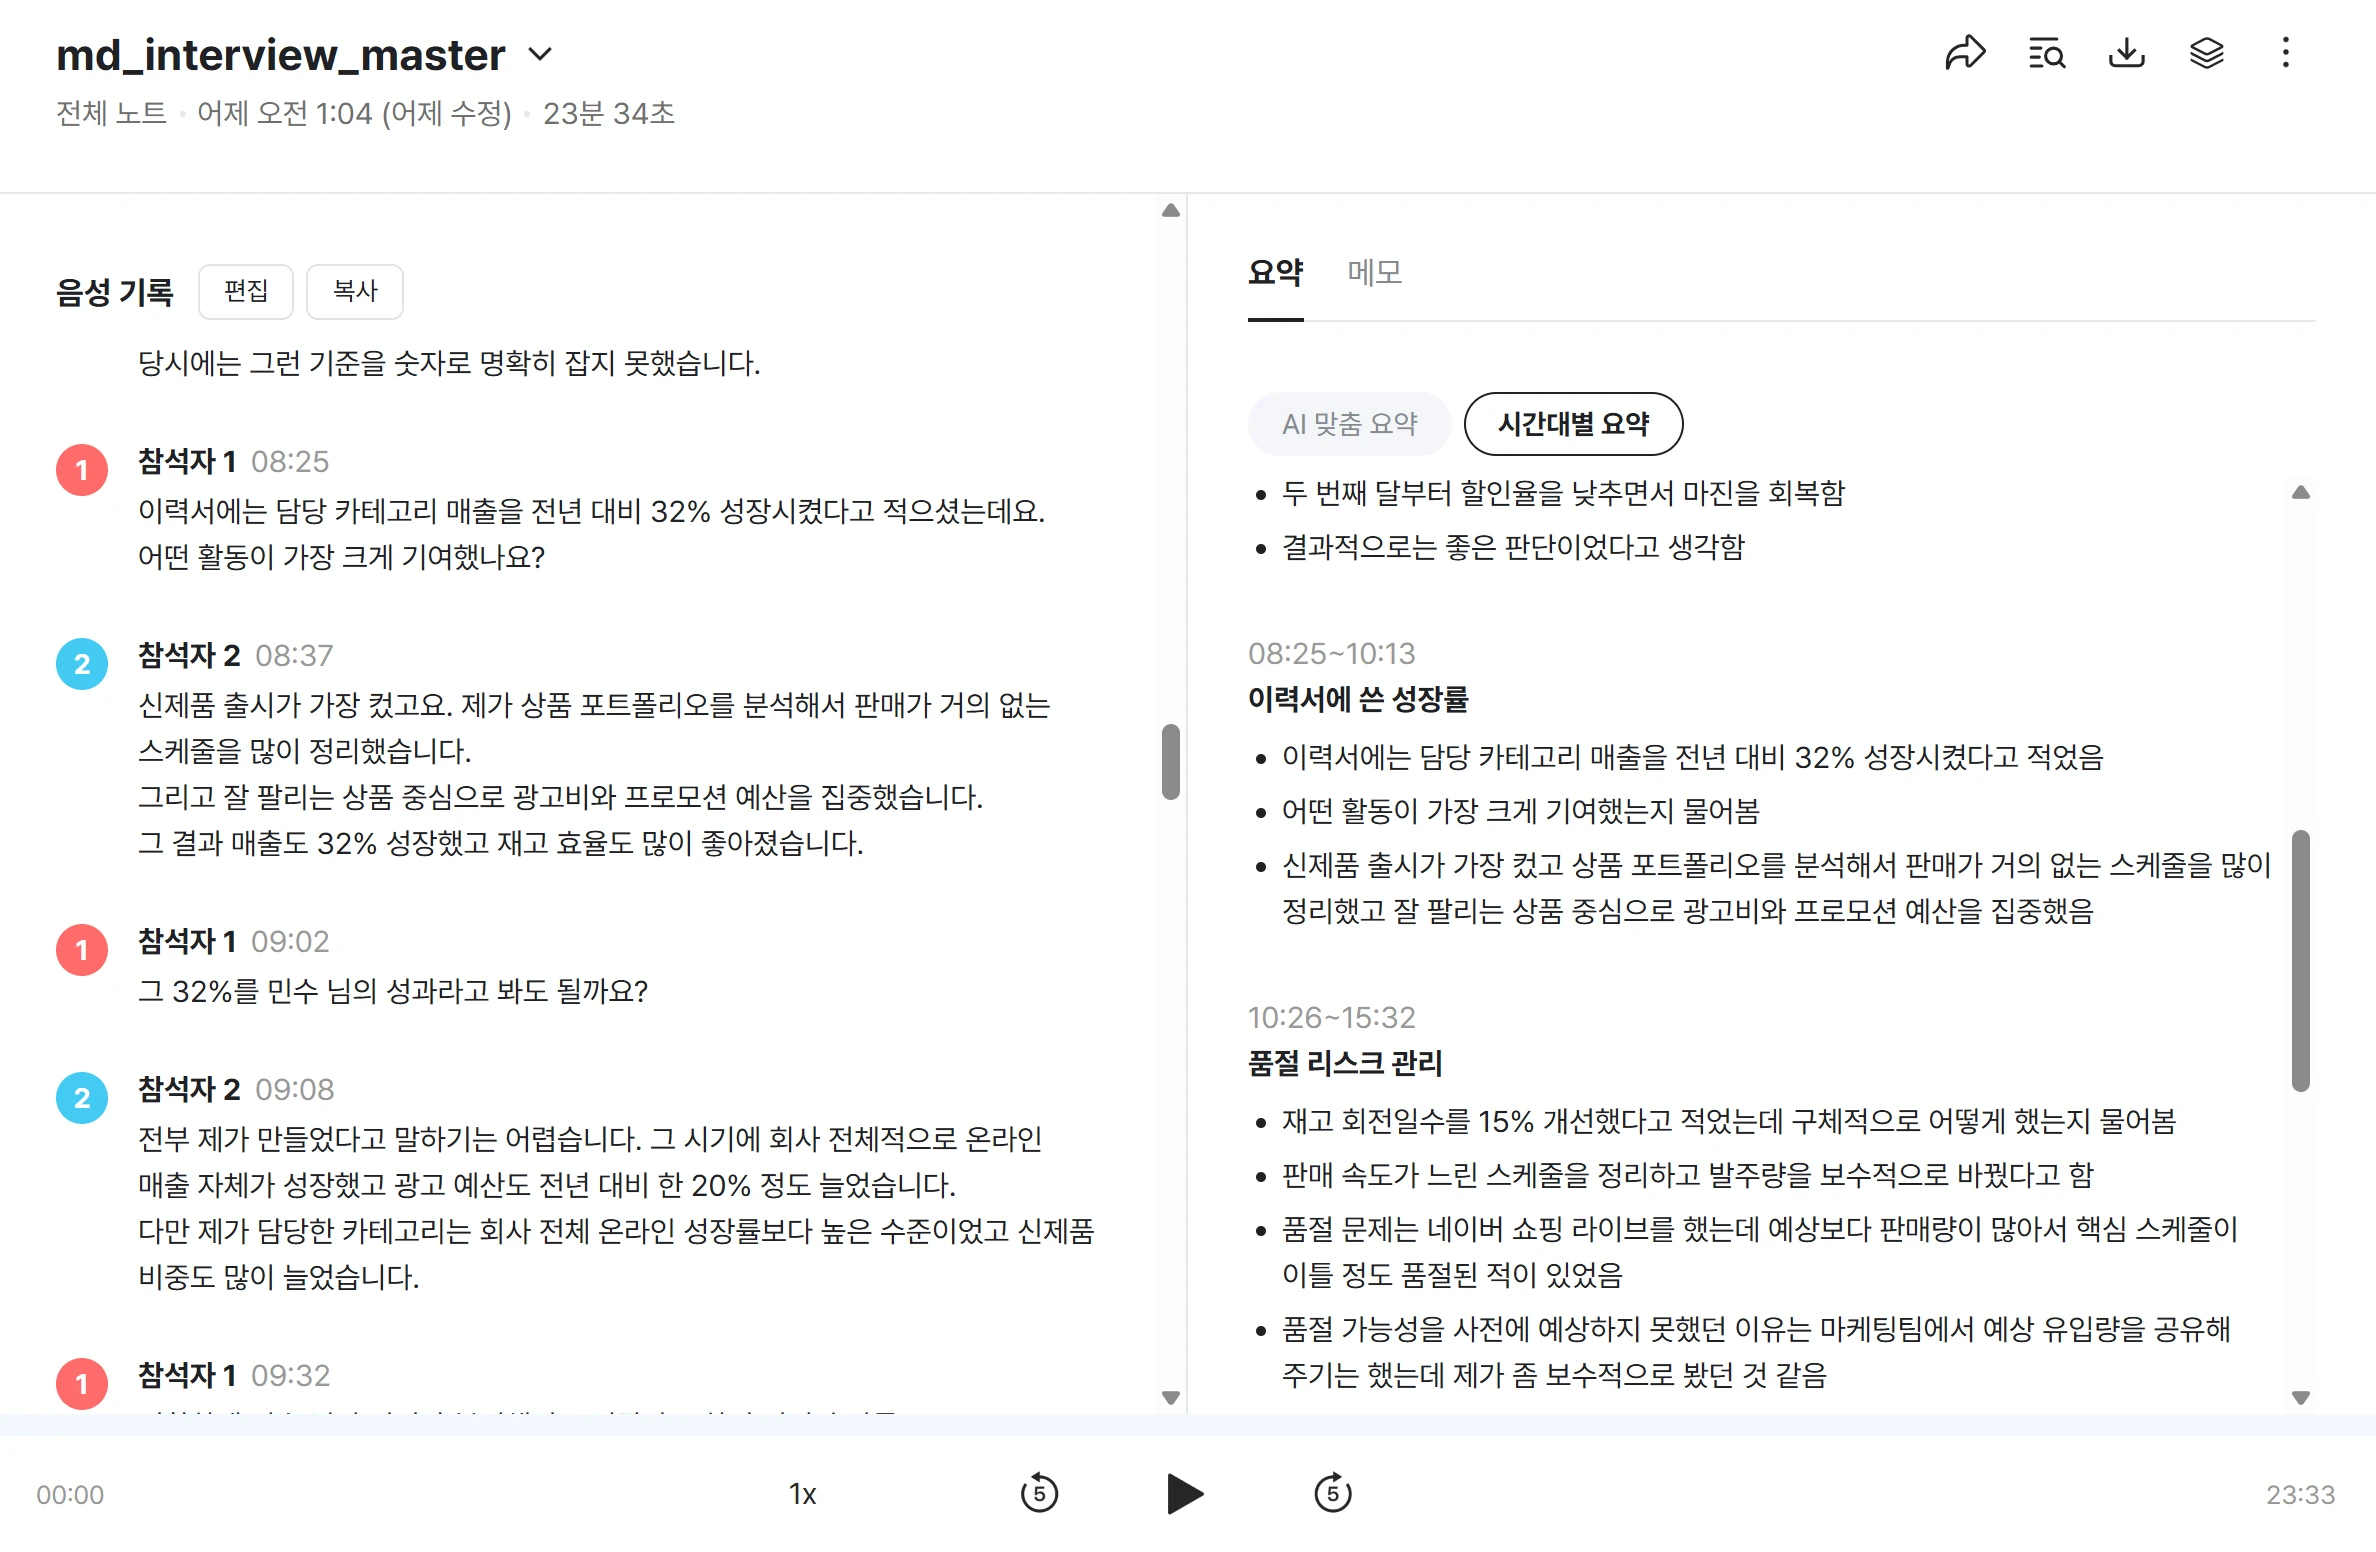
“32% 성장을 민수 님 성과라고 봐도 될까요?”라는 질문에 지원자는 같은 기간 회사 전체 온라인 매출이 늘었고 광고 예산도 약 20% 늘었다며, 전부 자신의 성과로 보기는 어렵다고 답했습니다.
클로바노트: 외부 요인이 요약에서 빠졌습니다
해당 시간대 요약에는 지원자가 한 활동은 남았지만, 광고 예산 증가와 회사 전체 온라인 성장이라는 외부 요인은 빠졌습니다.
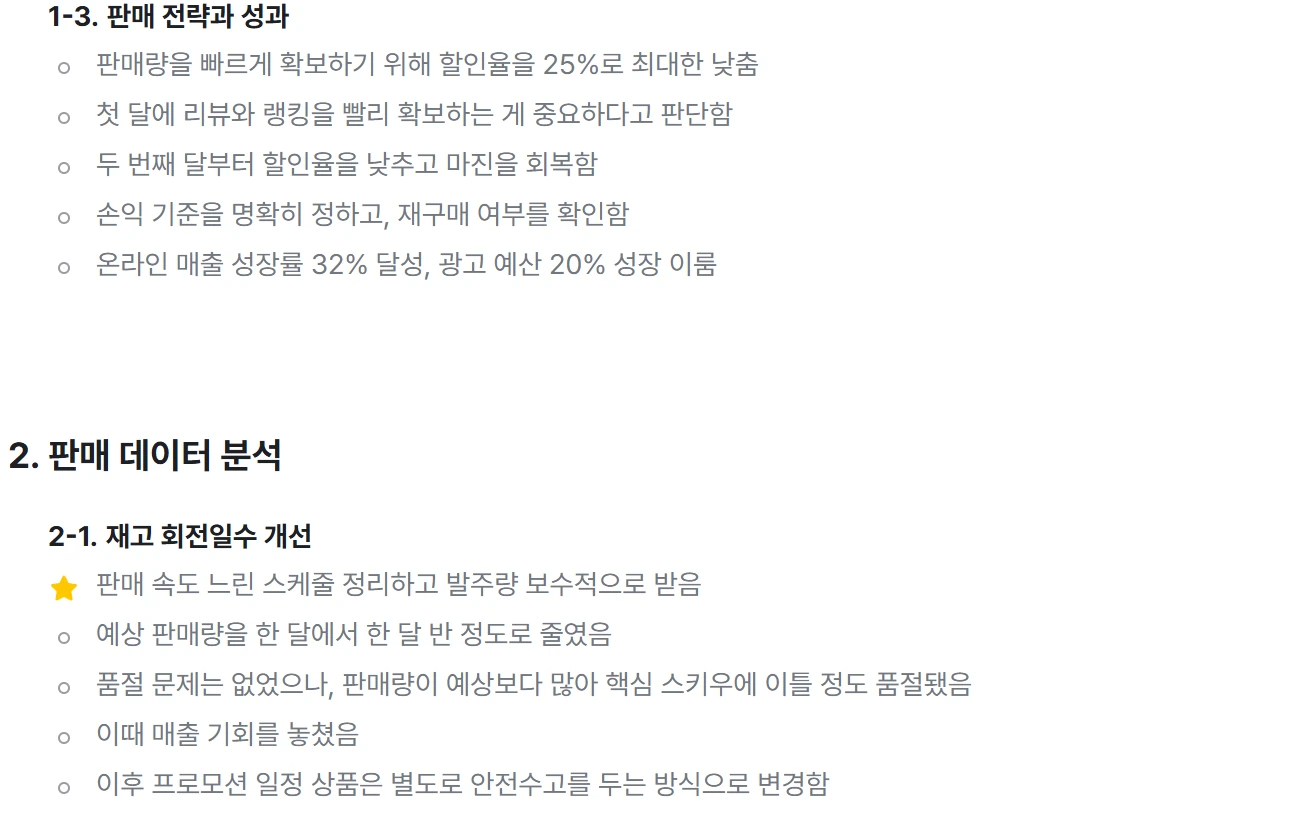
다글로: 외부 요인이 지원자의 성과처럼 들어갔습니다
기본 요약에서는 “광고 예산 20% 성장 이룸”이 지원자의 판매 전략·성과 아래에 들어갔습니다. 회사가 늘린 예산이 지원자 개인의 성과처럼 읽힐 수 있는 구조입니다.
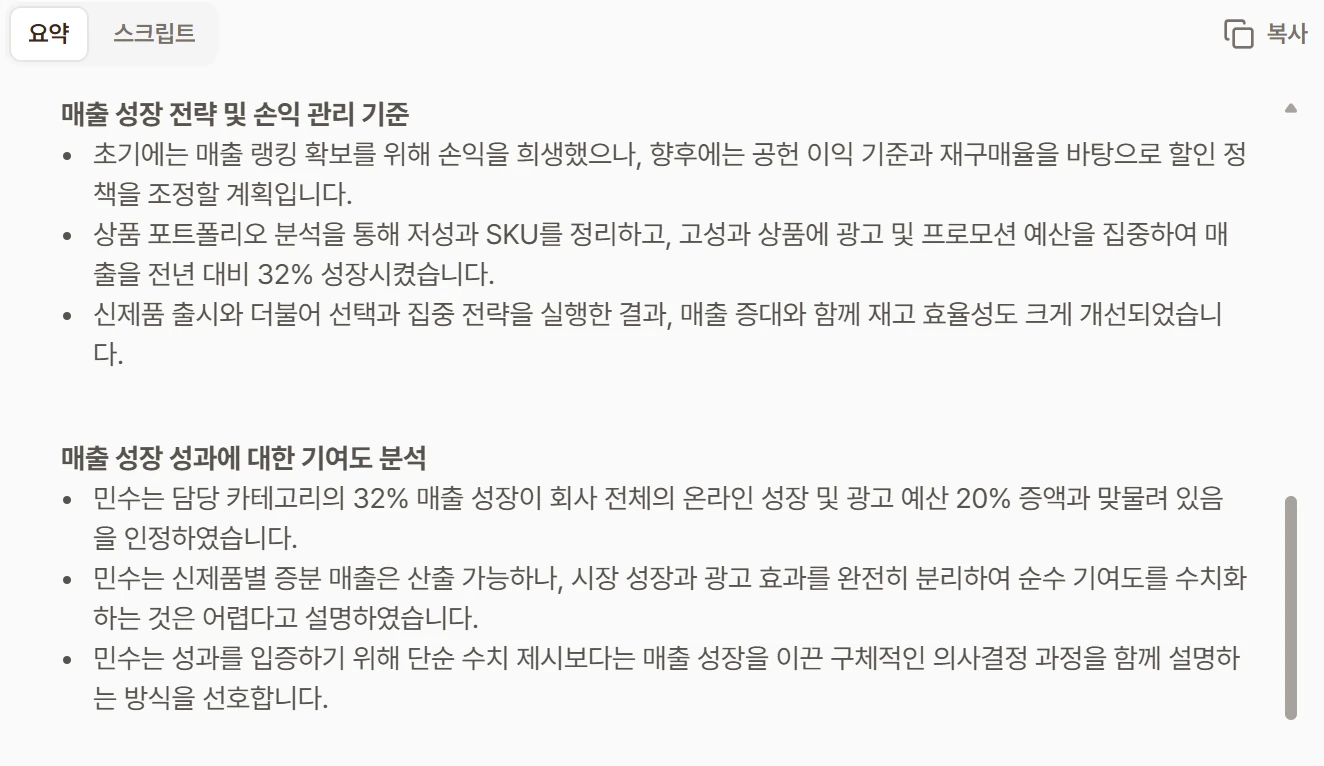
티로: 맥락은 잘 남겼지만 ‘판단’이 ‘사실’이 된 대목이 있었습니다
32% 성장 장면은 회사 전체 성장과 광고 예산 증가까지 비교적 충실하게 남겼습니다. 다만 다른 장면에서는 지원자가 직접 검증하지 않았다고 밝힌 “상품 자체 경쟁력”을 확인된 사실처럼 표현한 부분이 있었습니다.
4. 회의록 도구도 이제 ‘면접용 결과물’을 만듭니다
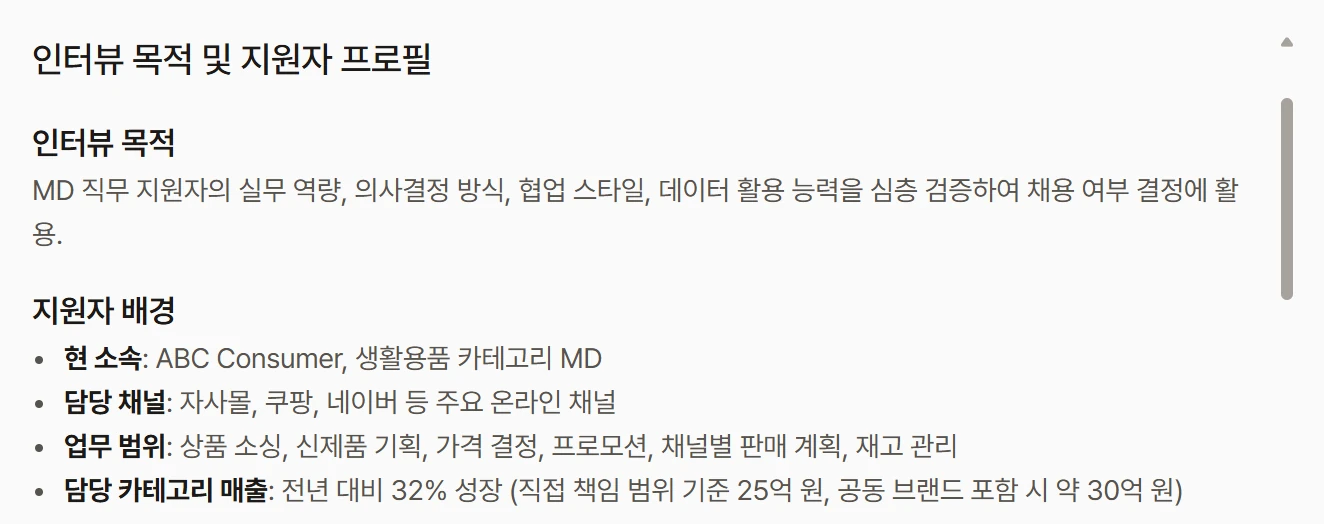
티로에는 ‘채용 인터뷰’, 다글로에는 ‘면접’ 템플릿이 기본으로 있습니다. 채용 맥락에 맞게 노트를 구조화하려는 니즈가 이미 범용 회의록에도 반영돼 있습니다.
티로: Q&A 기록 문서
평가를 대신하기보다 질문·답변 중심으로 정리하는 방식이었습니다. 25억·30억의 범위 차이와 32% 성장의 외부 요인도 충실하게 남았습니다.
다글로: 별도 프롬프트 없이 평가 보고서까지
다글로의 ‘면접’ 템플릿은 지원자 소개, 핵심 역량, 성향·조직 적합성, 장점, 보완점, 종합 평가까지 생성했습니다. 각 평가에 발화와 타임스탬프도 붙었습니다.
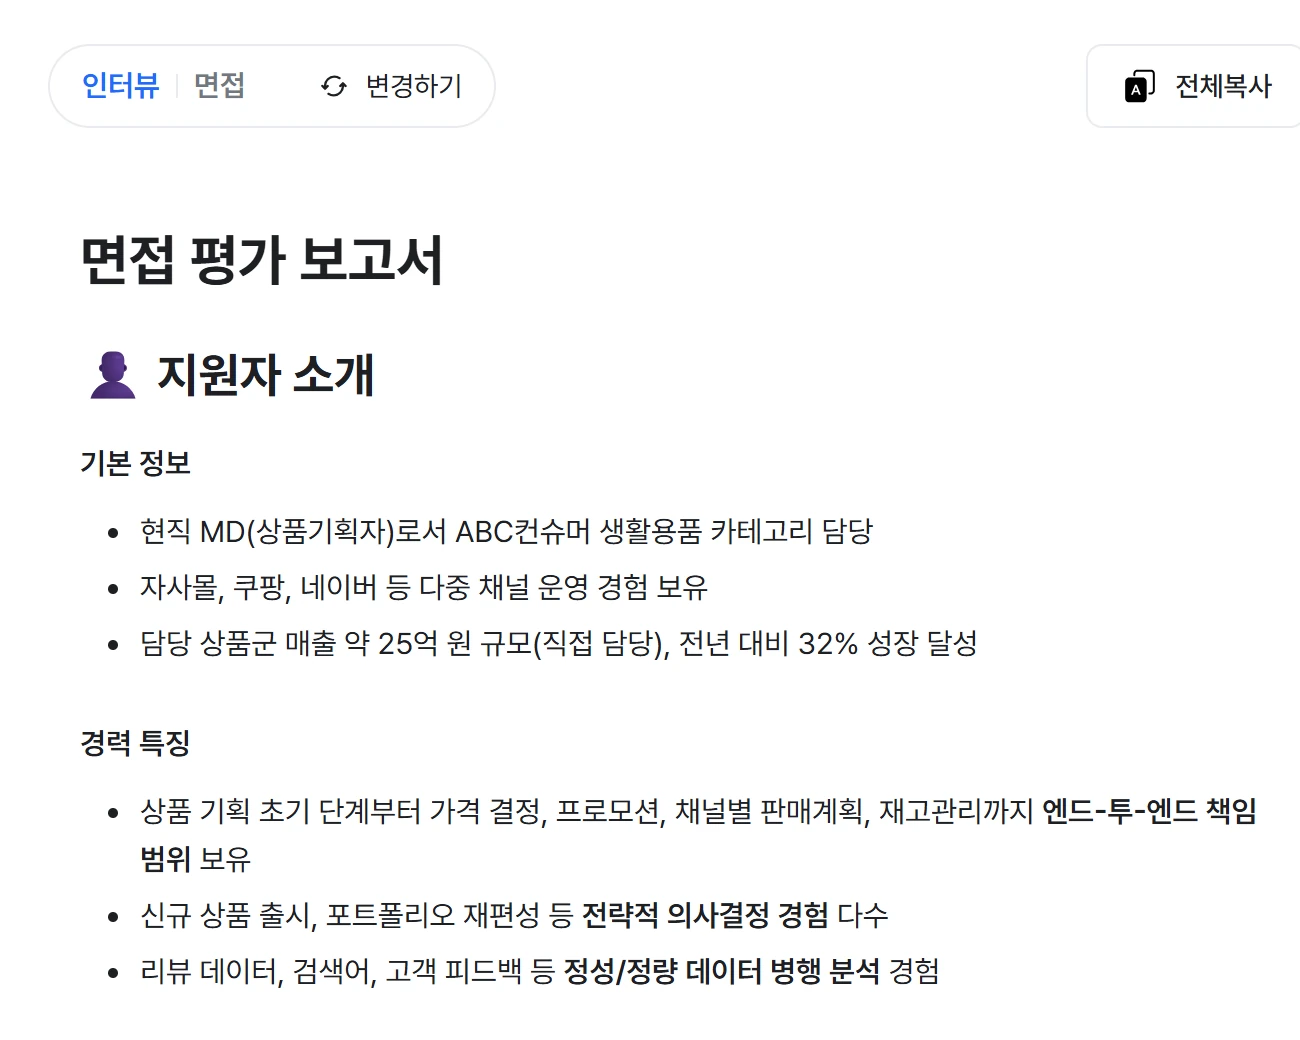
다만 같은 음원을 세 번 돌리자 직무 해석(‘MD(마케팅 담당자)’ → ‘MD(상품기획자)’ → ‘Merchandise Director’)과 최종 추천 유무가 매번 달랐습니다.
면접 노트테이킹은 이미 글로벌 회의록 제품에서도 하나의 독립적인 use case입니다
국내외 범용 회의록 제품이 채용 인터뷰를 별도 use case로 다룬다는 점은, 면접 노트테이킹·요약 니즈가 이미 보편적이라는 신호입니다. 티로·다글로 외에 Notta(AI Interview Notetaker), tl;dv(Hiring & Recruiting)도 그렇습니다.
공식 페이지: Notta AI Interview Notetaker ↗ · tl;dv Hiring & Recruiting ↗
그래서 어떤 상황에 무엇을 쓰면 될까요?
이미 나온 답을 잘 기록하는 것과, 아직 나오지 않은 답을 끌어내는 것은 다른 문제입니다.
이번 테스트에서 범용 AI 회의록은 첫 번째 문제를 상당히 잘 풀고 있었습니다. 기록의 품질은 “무엇을 말했는가”를 남기는 문제입니다. 면접의 품질은 “무엇을 더 물었어야 하는가”까지 다루는 문제입니다. 다음 글에서는 AI가 면접 중 놓치기 쉬운 검증 질문을 보완할 수 있는지 테스트합니다.
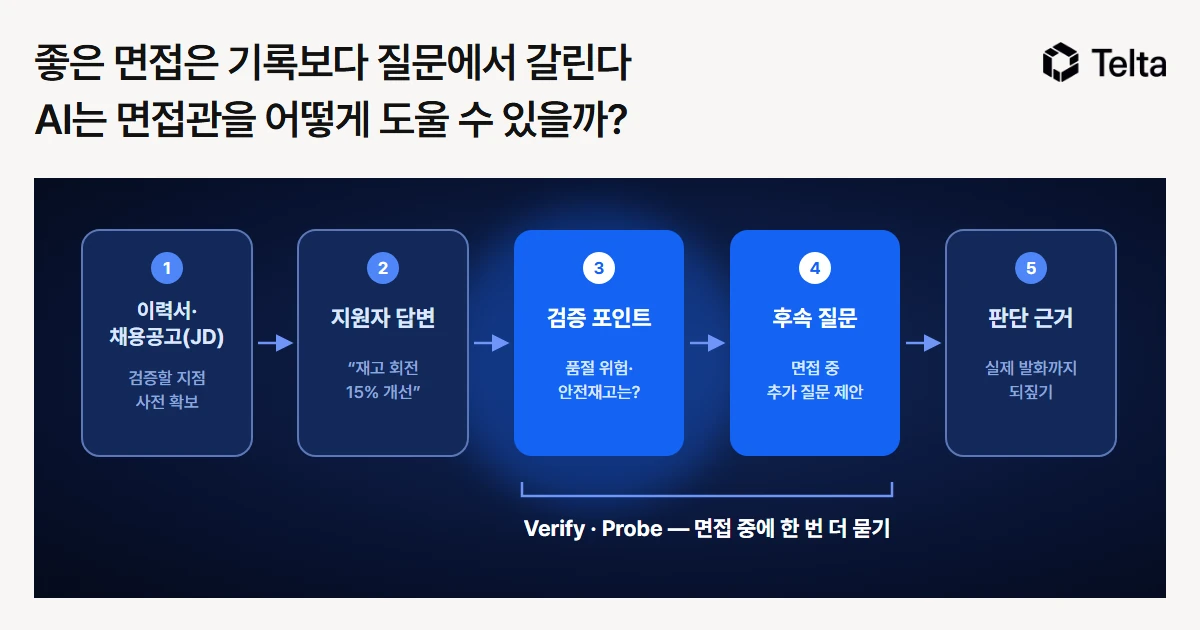
시리즈 2편: 좋은 면접은 기록보다 질문에서 갈린다 — AI는 면접관을 어떻게 도울 수 있을까? →
테스트 조건: 2026년 10월 11~12일, 약 23분 30초의 동일 합성음성 모의면접 1건. 각 도구의 기본 기능·기본 템플릿만 사용했고 별도 분석 프롬프트는 넣지 않았습니다(다글로 ‘면접’ 템플릿은 3회 실행). Notta·tl;dv는 공식 페이지에서 채용 use case만 확인했습니다. 제한된 조건의 관찰 결과이며 제품 전체의 성능 순위를 뜻하지 않습니다.
함께 읽어보면 좋은 글