리더십 진단 결과, 낮은 점수를 바로 개선과제로 바꾸면 안 되는 이유
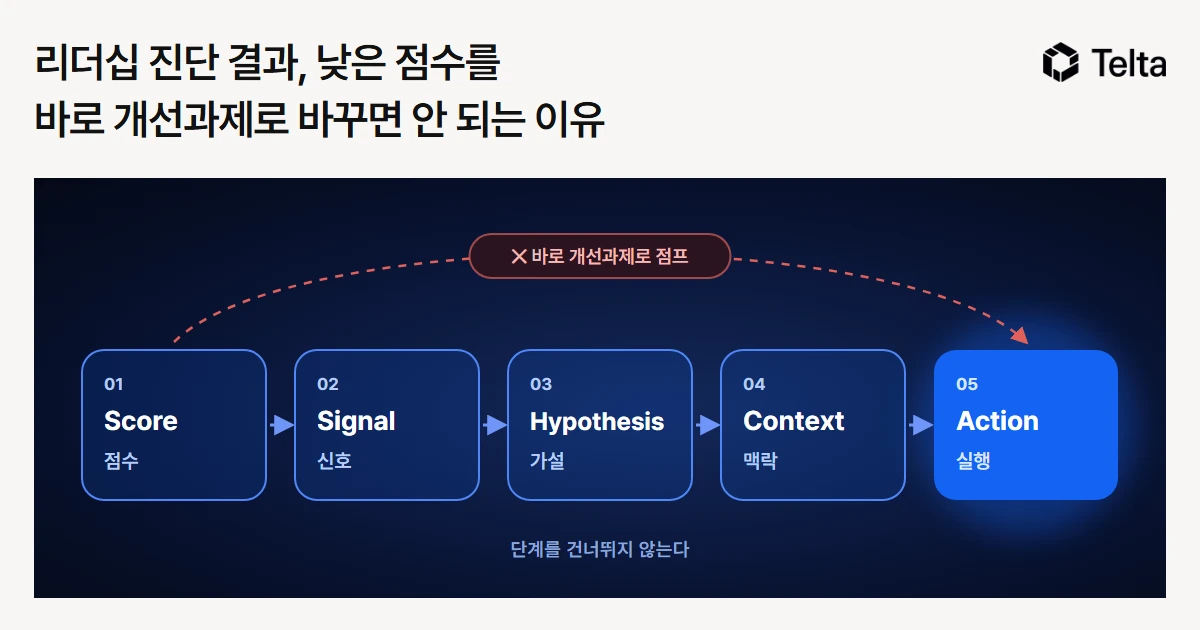

리더십 진단에서 가장 위험한 순간은 점수가 낮게 나온 때가 아니라, 그 이유와 해결책을 너무 빨리 안다고 생각하는 순간일 수 있습니다.
리더십 진단에서 가장 낮은 점수를 발견했습니다.
구성원 육성 2.9점
그러면 자연스럽게 “그래서 뭘 개선해야 하지?”라고 묻게 됩니다. 그런데 실제로는 그 전에 확인해야 할 것이 있습니다. 낮은 점수가 무엇의 신호인지 아직 모르기 때문입니다.
핵심 답변
낮은 점수는 원인이 아니라 Signal입니다. Score → Signal → Hypothesis → Context → Action으로 한 단계씩 해석해야 엉뚱한 개선과제를 피할 수 있습니다.
실제로 실패한 리더들의 360도 피드백에는 공통된 신호가 있었습니다
Jack Zenger와 Joseph Folkman은 360도 피드백 데이터를 이용해 리더가 derail되는 패턴을 분석했습니다. 한 연구에서는 Fortune 500 임원 450명 이상의 데이터를 수집한 뒤 향후 3년 안에 해고된 31명을 살펴봤고, 별도로 11,000명 이상의 리더 중 효과성이 가장 낮게 평가된 하위 10%를 분석했습니다.
Fortune 500 임원 360도 데이터
이후 3년 내 해고된 임원
별도 리더 데이터셋
HBR, Zenger & Folkman (2009)의 연구 설계를 요약한 도식입니다.
중요한 건 360도 리포트에 “이 임원은 3년 뒤 해고됩니다”라고 적혀 있었던 것이 아니라는 점입니다. 대신 실제 실패와 연결될 수 있는 여러 개의 약한 신호가 존재했습니다.
리더십 진단의 역할도 이와 비슷합니다. 미래를 예언하기보다 그냥 지나쳐도 되는 점수인지, 더 깊게 확인해야 하는 신호인지 구분하는 것에 가깝습니다.
근거: Harvard Business Review, “Ten Fatal Flaws That Derail Leaders”
같은 ‘소통 3.0점’도 전혀 다른 문제일 수 있습니다
가장 쉬운 해석은 “대화를 더 많이 해야겠다”입니다. 그래서 1on1이나 팀 미팅을 늘릴 수 있습니다. 조금 과장하면 회식을 늘릴 수도 있습니다.
중요한 정보가 늦게 공유된다.
결론과 결정 이유가 공유되지 않는다.
반대 의견을 말하기 어렵다.
리더는 많이 말하지만 충분히 듣지 않는다.
피드백은 많지만 다음 행동이 모호하다.
상위 조직의 방향이 팀까지 내려오지 않는다.
같은 ‘소통 저점’ 아래 서로 다른 원인이 숨어 있을 수 있습니다. 원인이 다르면 처방도 달라집니다.
소통 점수가 낮다는 것은 관찰된 결과이지, 원인에 대한 설명이 아닙니다.
Wells Fargo: 보이는 문제와 실제 원인이 달랐던 리더십 실패
Wells Fargo의 판매 관행 스캔들에서는 수천 명의 직원이 부적절한 판매행위로 해고됐고, 수백만 건의 잠재적 무단 계좌가 문제가 됐습니다. 이후 미국 연준과 OIG 자료는 강한 판매 목표와 경영진 압박, 위험의 적절한 상향 보고 실패, 거버넌스 문제를 지적했습니다.
특히 OIG는 당시 경영진과 이사회가 문제를 판매 모델 자체보다 개인 직원의 잘못된 행동으로 보는 경향이 있었다고 정리했습니다.
문제가 발생한 직원 개인을 중심으로 원인을 설명.
성과 인센티브와 경영·리스크 구조가 문제를 확대.
실제 조사 결과와 리더십 진단을 연결한 사고실험입니다. Wells Fargo 사례가 리더십 진단의 효과를 증명하는 것은 아니며, 가상의 진단 결과를 실제 사실처럼 제시하지 않습니다.
큰 리더십 실패는 항상 “아무 신호도 없다가 갑자기 사고가 나는” 형태로만 생기지 않습니다. 작은 신호가 있었지만 그 의미를 너무 좁게 해석했거나 중요성을 낮게 봤을 가능성도 있습니다.
근거: Federal Reserve (2018) · Federal Reserve OIG (2020) · HBR (2016)
평가자별 점수 차이도 ‘오차’가 아닐 수 있습니다
Ron Carucci가 HBR에 소개한 한 임원은 약 25명의 이해관계자에게서 극단적으로 다른 평가를 받았습니다. 어떤 사람은 지원적이고 배려 깊다고 했고, 다른 사람은 자기중심적이라고 평가했습니다. 일부는 자율성을 준다고 느꼈고, 다른 일부는 지나치게 간섭한다고 느꼈습니다.
필요할 때 도움을 준다.
자기 관점이 강하다.
세세하게 간섭하지 않는다.
지나치게 관여한다고 느낀다.
상반된 피드백은 평균으로 지워야 할 잡음이 아니라, 리더가 상황별로 다르게 경험되고 있다는 중요한 단서일 수 있습니다.
근거: Harvard Business Review, “How to Make Sense of Conflicting Feedback on Your Leadership”
평가자별 점수가 다를 때는 무엇부터 봐야 할까요?
예를 들어 자기평가는 4.3점인데 구성원 평가는 3.1점이라고 해보겠습니다. 이 차이만 보고 곧바로 “자기인식이 부족하다”고 결론 내리기보다, 최소한 다음 네 가지를 함께 확인하는 편이 안전합니다.
자기평가와 타인평가의 차이가 어떤 행동 문항에서 발생하는지 봅니다.
위로 보고할 때와 아래로 리딩할 때 행동이 다를 수 있습니다.
특정 조직·역할·관계에서만 차이가 나타나는지 확인합니다.
‘소통’ 총점보다 경청, 정보 공유, 결정 설명 같은 관찰 가능한 행동을 봅니다.
그렇다면 몇 점 차이가 나야 ‘의미 있는 차이’일까요?
모든 리더십 진단에 공통으로 적용할 수 있는 “0.3점”, “0.5점” 같은 절대 기준은 없습니다. 사용하는 척도, 문항 신뢰도, 평가자 수, 규준, 신뢰구간과 결과 분포에 따라 같은 점수 차이의 의미가 달라질 수 있기 때문입니다.
그래서 실무에서는 숫자 하나보다 다음을 같이 보는 편이 좋습니다.
- 방향이 반복되는가? 여러 문항에서 같은 방향의 차이가 나타나는가?
- 특정 집단에 집중되는가? 구성원에게만 반복적으로 낮게 평가되는가?
- 행동 수준에서 설명 가능한가? 추상적 역량이 아니라 실제 행동 문항에서 패턴이 보이는가?
- 맥락과 맞아떨어지는가? 주관식 의견이나 실제 업무 상황에서도 비슷한 신호가 확인되는가?
즉 점수 차이가 크다고 해서 반드시 문제가 더 크다는 뜻도 아니고, 작은 차이라고 해서 무조건 무시해도 된다는 뜻도 아닙니다.
그래서 ‘점수 → 액션’ 사이에는 몇 단계가 더 필요합니다
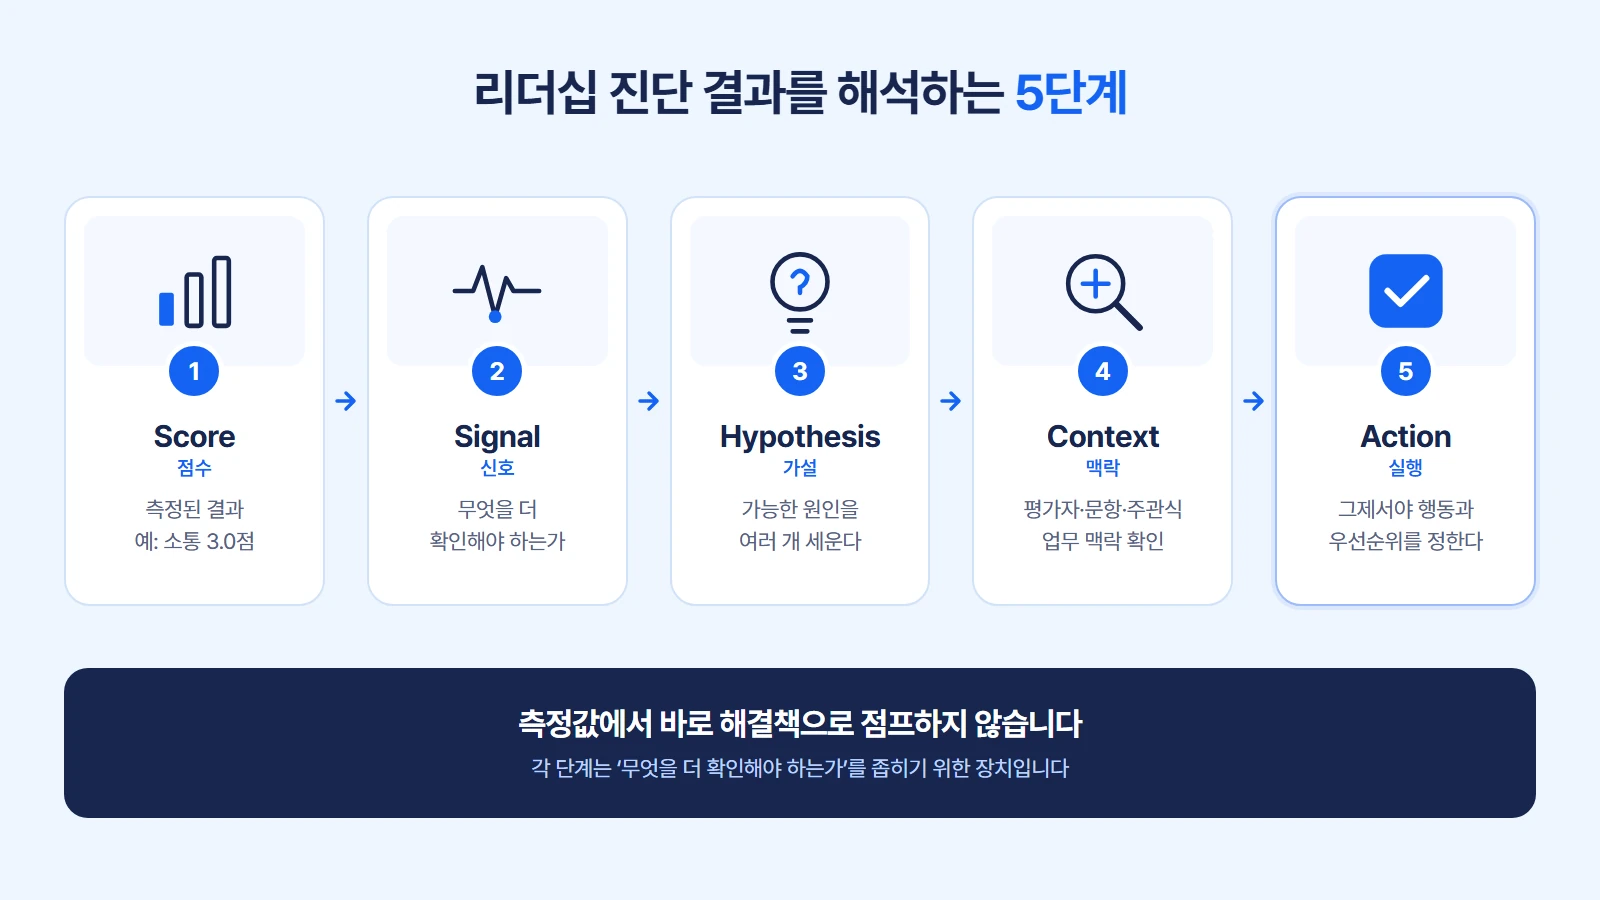
360도 피드백이 실제 변화로 이어지는 것도 자동적이지 않습니다. 24개 종단연구를 메타분석한 Smither, London, Reilly는 시간에 따른 평가 개선폭이 전반적으로 작았다고 보고했고, 변화 필요성 인식, 피드백 수용, 목표 설정과 행동 등이 중요하다고 설명했습니다. 2026년 HBR도 360도 결과를 받은 뒤 실제 동료와 의미를 논의하는 과정의 중요성을 강조했습니다.
근거: Smither, London & Reilly (2005) · HBR (2026)
좋은 리더십 진단은 “무엇을 고치세요”라고 빨리 말하는 진단이 아니라, 어떤 신호를 그냥 지나치면 안 되는지 알려주는 진단에 가깝습니다.
Telta는 ‘정답을 대신 내리는 AI’보다 해석의 공백을 줄이는 쪽에 가깝습니다
리더십 진단에서 AI가 낮은 점수를 발견한 뒤 곧바로 “소통 교육을 받으세요”라고 결론 내리면, 이 글에서 지적한 오류를 그대로 반복하게 됩니다.
Telta가 리더십 진단 리포트와 Report Assistant에서 중요하게 보는 것은 리포트 안의 결과를 더 쉽게 탐색하고, 평가자별 차이와 세부 결과를 확인하며, 다음에 무엇을 물어봐야 할지 좁혀가는 과정입니다.
리포트 안에서 필요한 결과를 빠르게 찾아본다.
세부 결과와 평가자 차이를 함께 본다.
원인을 단정하기보다 확인할 질문을 구체화한다.
제품 성과·정확도에 대한 수치를 주장하지 않습니다. 핵심은 리포트 해석 과정의 지원입니다.
리더십 진단 결과 해석 FAQ
1. 리더십 진단에서 가장 낮은 점수부터 개선해야 하나요?
반드시 그렇지는 않습니다. 낮은 점수는 우선 확인해야 할 신호입니다. 세부 문항, 평가자 집단별 차이, 주관식 의견과 업무 맥락을 함께 보고 원인 가설을 검토한 뒤 우선순위를 정하는 편이 안전합니다.
2. 360도 피드백에서 평가자별 점수가 크게 다른 이유는 무엇인가요?
평가자마다 리더와 상호작용하는 상황과 관계가 다르기 때문일 수 있습니다. 평균으로 합치기 전에 어느 집단에서 어떤 경험 차이가 나타나는지 확인하면 중요한 맥락을 얻을 수 있습니다.
3. 리더십 진단 결과를 실제 행동으로 연결하려면 어떻게 해야 하나요?
Score를 보고 바로 Action으로 넘어가기보다 Signal을 정의하고, 가능한 Hypothesis를 세운 뒤, 평가자별 결과와 실제 업무 Context를 확인하고 Action을 정하는 순서가 유용합니다.
4. 360도 진단에서 자기평가와 구성원 평가 차이는 어떻게 해석해야 하나요?
차이 자체를 곧바로 자기인식 부족으로 단정하지 않는 편이 좋습니다. 어떤 행동 문항에서 차이가 나는지, 다른 평가자 집단에서도 같은 패턴이 반복되는지, 표본 수와 응답 맥락은 어떤지 먼저 확인해야 합니다.
5. 상사·동료·구성원 중 누구의 점수를 더 중요하게 봐야 하나요?
보편적으로 항상 더 중요한 평가자 집단은 없습니다. 평가하려는 행동을 실제로 관찰할 기회가 있는 집단인지, 진단 목적이 무엇인지에 따라 해석 가치가 달라집니다.
6. 0.3점이나 0.5점 차이는 의미 있는 차이인가요?
모든 진단에 적용할 수 있는 보편적인 절대 기준은 없습니다. 척도, 신뢰도, 평가자 수, 규준과 신뢰구간 등에 따라 달라질 수 있으므로 반복되는 방향성과 세부 행동 패턴을 함께 봐야 합니다.
7. AI가 리더십 진단 결과의 원인을 자동으로 찾아줄 수 있나요?
진단 데이터만으로 실제 원인을 단정하는 것은 위험합니다. AI는 결과를 탐색하고 비교하거나 다음에 확인할 질문을 좁히는 보조도구로 활용하고, 최종 원인 판단은 조직 맥락과 추가 확인을 함께 보는 것이 적절합니다.
참고 자료
- Zenger & Folkman, HBR (2009)
- Federal Reserve, Wells Fargo enforcement action (2018)
- Federal Reserve OIG, Wells Fargo investigation summary (2020)
- Ron Carucci, HBR (2022)
- Smither, London & Reilly, Personnel Psychology (2005)
- Brenda Steinberg, HBR (2026)
함께 읽어보면 좋은 글